Zabbix
Zabbix 8.0 LTS por dentro: o motor que sustenta a nova geração do monitoramento
No primeiro artigo desta série, falamos das novidades que mais chamam atenção no Zabbix 8.0: OpenTelemetry, logs, processamento complexo de eventos e integração nativa com agentes de IA. Mas nenhuma dessas ambições se sustenta sem um núcleo capaz de aguentar a carga. Traces, logs e payloads estruturados multiplicam o volume de dados. Correlação de eventos em janelas de tempo exige processamento rápido. E uma plataforma que se propõe a ser o centro da operação precisa ser tão disponível quanto os sistemas que ela vigia.
É desse núcleo que trata este segundo artigo. Performance e escalabilidade, alta disponibilidade, novos tipos de dados, o novo modelo de armazenamento de histórico e, por fim, uma parte que costuma ficar de fora dos resumos de novidades, mas que decide o sucesso de um projeto: o que muda de forma incompatível e precisa ser preparado antes do upgrade.
Status das funcionalidades. Diferente do bloco de observabilidade e IA, boa parte do que está neste artigo já aparece na documentação oficial do 8.0 e nas versões alpha e beta publicadas: ClickHouse, tipo de dado JSON, suporte a múltiplos hosts PostgreSQL, melhorias de SNMP e cache de DNS, entre outros. As exceções são as “melhorias massivas de performance”, ainda marcadas como em desenvolvimento no roadmap, e as permissões para proxies, que estão em fase de testes com previsão para a release candidate. A documentação consultada é a da versão de desenvolvimento e pode sofrer ajustes até o lançamento, previsto para outubro de 2026.
Performance e escala: rumo ao milhão de valores por segundo
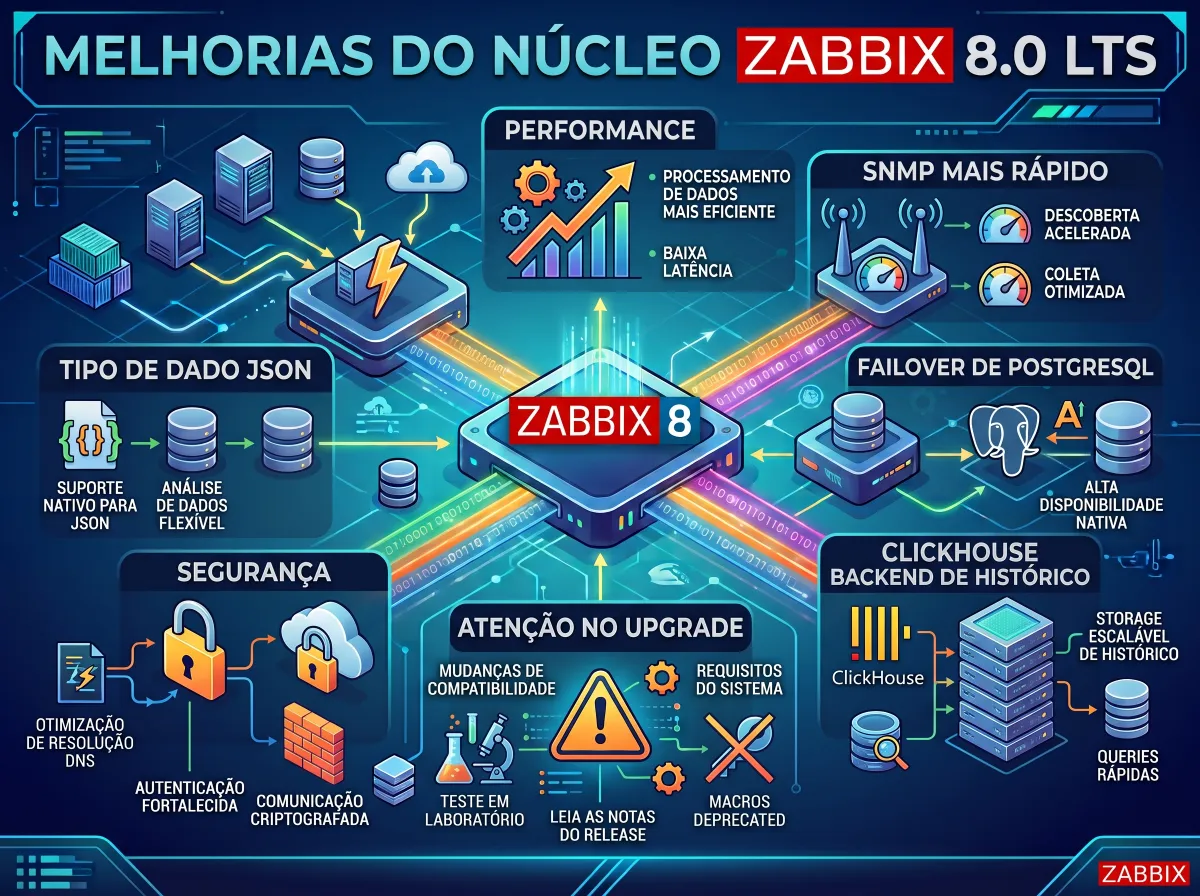
O roadmap do 8.0 promete melhorias massivas de performance, com capacidade de coletar milhões de valores por segundo, graças a um Zabbix Server muito mais eficiente e ao suporte flexível a motores de armazenamento pensados para implantações em grande escala. No Zabbix Summit 2026, o Lead Product Owner da Zabbix tem uma palestra dedicada exatamente a mostrar como os novos recursos do 8.0 permitem chegar a 1 milhão de novos valores por segundo (NVPS). Para dimensionar o salto: um dos casos apresentados no mesmo evento é o de uma operadora finlandesa que roda uma arquitetura altamente disponível com cerca de 2.500 hosts e aproximadamente 7.000 NVPS. Ambientes muito maiores do que isso existem, mas a ordem de grandeza mostra que o 8.0 mira um patamar em que poucas instalações chegam hoje.
É importante separar aqui o que é promessa do que já está no código. O item de melhorias massivas ainda está em desenvolvimento. Já as otimizações que atacam gargalos conhecidos do dia a dia estão documentadas, e são elas que vão fazer diferença primeiro para a maioria das empresas.
A primeira delas é no SNMP, protocolo que continua sendo a espinha dorsal do monitoramento de redes. No SNMPv3, o Zabbix passa a guardar em cache e reutilizar o EngineID dos dispositivos, evitando a etapa de descoberta a cada consulta. O pedido original dessa melhoria foi aberto na comunidade em 2014 e finalmente é entregue no ciclo do 8.0. Além disso, as verificações SNMPv1 e SNMPv2 passam a ser processadas de forma concorrente. Para um provedor de internet ou uma operadora que monitora milhares de switches, roteadores, OLTs e rádios, isso significa menos pollers ocupados, menos fila e intervalos de coleta mais curtos com o mesmo hardware. E para quem migrou para SNMPv3 por exigência de segurança e sentiu o impacto no desempenho, é uma dívida antiga sendo paga.
A segunda é a resolução de nomes. Server, proxy e agente passam a poder usar a biblioteca c-ares para todas as requisições de DNS, com cache de consultas e failover entre resolvedores. Parece um detalhe, mas quem já administrou um ambiente com milhares de hosts cadastrados por nome sabe o que acontece quando o DNS fica lento ou instável: uma avalanche de hosts “inalcançáveis” que parece falha de rede e não é. Com cache e troca automática de resolvedor, uma família inteira de falsos positivos simplesmente desaparece. É o tipo de melhoria que ninguém nota até a madrugada em que ela evita um incidente fantasma.
Completam o pacote um startup do servidor mais rápido, com carregamento de histórico em lote, um housekeeping otimizado, melhorias de desempenho no uso do Elasticsearch e um ajuste fino no controle de vazão dos proxies durante a recuperação do cache de histórico. Esse último ponto é relevante para quem opera ambientes distribuídos: quando um proxy fica horas desconectado e volta com um buffer cheio, ele não pode afogar o servidor com dados atrasados. O refinamento desse mecanismo torna a recuperação de incidentes de conectividade mais previsível.
ClickHouse: quando o banco relacional deixa de ser suficiente
Se existe uma dor universal entre administradores de Zabbix em ambientes grandes, ela tem nome: o tamanho das tabelas de histórico. Particionamento, TimescaleDB, ajustes de housekeeping, retenções agressivas — todo mundo que opera Zabbix em escala já passou por essa luta. O 8.0 traz uma resposta estrutural: o ClickHouse pode ser usado como backend para armazenar o histórico de valores dos itens.
O ClickHouse é um banco de dados colunar, desenhado para análise de grandes volumes com alta compressão e consultas agregadas muito rápidas. No Zabbix 8.0, ele armazena os tipos numérico inteiro e decimal, caractere, log, texto e o novo tipo JSON. Mas há detalhes de arquitetura que precisam ser entendidos antes de qualquer decisão, e a documentação oficial é clara sobre eles. O Zabbix não calcula nem armazena tendências (trends) no ClickHouse, o que significa que a estratégia de retenção precisa ser repensada, possivelmente estendendo o período de histórico. O housekeeper do Zabbix não apaga dados no ClickHouse; a retenção é controlada pelo TTL do próprio banco, que por padrão é de 31 dias. O ClickHouse não é suportado nos proxies. E em clusters com replicação e sharding, a configuração do Zabbix aceita apenas uma URL, por isso a recomendação é colocar um balanceador de carga na frente dos nós.
Junto com essa entrega vem uma mudança de modelo que vai além do ClickHouse. Os antigos parâmetros de armazenamento externo de histórico dão lugar a um novo parâmetro, HistoryProvider, no servidor, e à variável $HISTORY_PROVIDERS, no frontend. Na prática, o histórico deixa de ser “o banco do Zabbix” e passa a ser um provedor plugável, que pode ser SQL, Elasticsearch ou ClickHouse, inclusive com tipos de valor diferentes indo para destinos diferentes. Quem já usa Elasticsearch como backend também será afetado por essa mudança de configuração. A Zabbix publica ainda scripts de migração do histórico existente de MySQL ou PostgreSQL para o ClickHouse.
O cenário de uso mais óbvio é o de ambientes grandes, com milhões de itens e necessidade de guardar histórico bruto por mais tempo, seja por requisito regulatório, seja para análise. Outro cenário interessante é o de quem já pensa em alimentar modelos de detecção de anomalias ou agentes de IA com dados do Zabbix: um banco colunar é muito mais adequado para consultas analíticas pesadas do que um banco transacional. Mas o ClickHouse não é uma bala de prata. Ele introduz uma nova tecnologia na operação, com seus próprios requisitos de dimensionamento, backup, monitoramento e conhecimento técnico. Para muitos ambientes de porte médio, um PostgreSQL com TimescaleDB bem ajustado continua sendo a escolha mais simples e suficiente. O Summit 2026 traz uma palestra e um workshop inteiro sobre o tema, o que mostra o peso que a Zabbix dá a essa mudança.
JSON como tipo de dado nativo
Até a versão 7.4, um JSON retornado por uma API era coletado em um item do tipo texto, armazenado como string e limitado a 64 KB. No 8.0, JSON passa a ser um tipo de dado de primeira classe, com limite de 128 MiB e validação: valores com chaves sem aspas, vírgulas sobrando ou colchetes desbalanceados são rejeitados, em vez de serem gravados como lixo silencioso. O tipo é suportado por todos os tipos de item e protótipos, exceto os calculados, e também aparece na exportação em tempo real e nos conectores de streaming.
Existe uma restrição que os resumos costumam omitir e que muda o jeito de modelar: itens do tipo JSON não podem ser usados diretamente em triggers. Para alertar sobre um campo específico, o caminho continua sendo extrair o valor com um item dependente de outro tipo. Além disso, tanto o ClickHouse quanto o Elasticsearch não aceitam arrays JSON na raiz; o valor precisa ser um objeto ou um conjunto de objetos. Em outras palavras, o JSON nativo muda onde se guarda o volume, não como se alerta.
Onde isso faz diferença? Em todo o monitoramento baseado em APIs, que cresce a cada versão. Clusters Kubernetes, provedores de nuvem, hipervisores, firewalls de nova geração, plataformas SaaS: todos respondem em JSON, muitas vezes com payloads que passavam com folga dos 64 KB. Hoje, a solução comum é fatiar a resposta no pré-processamento e descartar o restante. Com o tipo JSON, o objeto completo fica disponível para investigação, auditoria e reprocessamento. E, conectando com o primeiro artigo desta série, é exatamente esse tipo de dado estruturado e completo que torna mais útil uma consulta feita por um agente de IA via MCP.
Na mesma linha de modelagem, o 8.0 traz melhorias que parecem pequenas, mas eram pedidos antigos da comunidade. As tags definidas em templates e hosts passam a ser visíveis nos itens e triggers que as herdam, as tags de triggers criadas por descoberta de baixo nível podem ser editadas manualmente, e o LLD aninhado ganha suporte a macros. Como vimos no artigo anterior, tags bem modeladas serão a base do processamento complexo de eventos, e essas mudanças deixam o modelo de dados mais transparente e controlável.
Alta disponibilidade: o banco de dados deixa de ser o elo fraco
O Zabbix tem alta disponibilidade nativa do servidor desde a versão 6.0 e grupos de proxies com balanceamento e failover desde a 7.0. O elo que continuava frágil era o banco de dados. Muitas empresas já rodam PostgreSQL em cluster com ferramentas como Patroni, mas o Zabbix só aceitava um único endereço de banco na configuração do servidor e do frontend. Para que o failover do banco fosse transparente, era preciso colocar um IP virtual, um HAProxy ou algum outro componente no meio.
O 8.0 resolve isso com o suporte a múltiplos hosts PostgreSQL. O pedido original, aberto na comunidade em 2021, descrevia exatamente o cenário de clusters Patroni: permitir que o Zabbix conheça vários endereços e se conecte sempre ao nó ativo em casos de failover ou switchover. A funcionalidade foi entregue no beta1 e aparece no roadmap como falha automática para o backend PostgreSQL.
O efeito prático é menos uma peça na arquitetura e menos um ponto de falha. Em um cenário de manutenção planejada do banco, o switchover acontece sem editar arquivos de configuração nem depender de uma camada extra de rede. Em uma falha real do nó primário, o Zabbix encontra o novo primário sozinho. O caso da operadora finlandesa apresentado no Summit, que combina servidores Zabbix em HA, um cluster PostgreSQL gerenciado por Patroni em servidores físicos e seis grupos de proxies, é um retrato do tipo de arquitetura que passa a ser mais simples de montar e operar com o 8.0.
Segurança e governança: o Zabbix como plataforma multiusuário
Um conjunto de mudanças do 8.0 aponta para ambientes em que o Zabbix é compartilhado entre várias equipes, unidades de negócio ou clientes. A mais relevante é o novo modelo de permissões para proxies e grupos de proxies, semelhante ao que já existe para grupos de hosts. O pedido nasceu de provedores de serviços gerenciados que precisavam impedir que um cliente enxergasse ou escolhesse proxies de outros clientes. A funcionalidade está em fase de testes, com previsão para a release candidate.
Outras entregas reforçam a postura de segurança: certificados SAML podem ser carregados diretamente pela interface para o login único, a integração com o cofre de segredos HashiCorp Vault ganha autenticação pelo método AppRole, o registro de auditoria pode ser exportado em CSV a partir de filtros, e os agentes ganham os parâmetros AllowKeyRegexp e DenyKeyRegexp para controlar, por expressão regular, quais chaves podem ser executadas. Os templates e tipos de mídia baseados em HTTP passam a verificar o certificado TLS do destino por padrão, o que é mais seguro, mas pode quebrar integrações que apontam para endpoints com certificados autoassinados.
Para um órgão público que precisa comprovar em auditoria quem alterou o quê, para um banco que precisa demonstrar controles de acesso ou para um provedor que opera Zabbix para dezenas de clientes, esse conjunto de melhorias transforma práticas que antes dependiam de disciplina e scripts em recursos nativos.
A conta do upgrade: o que muda de forma incompatível
Toda versão LTS traz mudanças que quebram compatibilidade, e o 8.0 não é exceção. A primeira e mais pesada é a elevação das versões mínimas de banco de dados e PHP. O PostgreSQL mínimo sobe da versão 13 para a 15, o MySQL de 8.0.30 para 8.4, o MariaDB de 10.5 para 10.11, o TimescaleDB de 2.13 para 2.20 e o PHP de 8.0 para 8.2. Para muitas empresas, isso significa que atualizar o Zabbix começa por atualizar o banco onde mora todo o histórico, e esse costuma ser o trecho mais demorado e arriscado da janela de manutenção. Para quem usa MySQL criado com o conjunto de caracteres utf8mb3, a recomendação é converter para utf8mb4.
A segunda mudança está nas macros. O 8.0 remove de vez macros depreciadas há muito tempo, que ainda sobrevivem em textos de notificação de muitos ambientes, como {HOSTNAME}, {IPADDRESS}, {TRIGGER.COMMENT}, {TRIGGER.KEY}, {STATUS}, {USER.ALIAS}, {PROFILE.*} e as antigas macros de reconhecimento {ACK.*}. Todas têm substitutas que já funcionam nas versões 7.x. O risco aqui é silencioso: o que quebra não é um gráfico, é o texto do alerta, e um alerta quebrado só é percebido quando alguém precisa dele.
A terceira está na automação. A API perde o método massupdate nos objetos de host, template, grupo de hosts e grupo de templates, além de hostinterface.replacehostinterfaces. Scripts de integração com CMDB, pipelines de provisionamento e ferramentas de “Zabbix as code” precisam ser revisados. No pré-processamento em JavaScript, os métodos dos objetos nativos passam a ser somente leitura, o que invalida scripts que modificavam protótipos. Nos agentes, o caractere % entra na lista de UnsafeUserParameters. O plugin de Ceph do agente 2 passa a ser um plugin carregável, com etapas extras de instalação, e agentes anteriores à versão 1.6 deixam de ser suportados.
Há ainda um detalhe operacional que vale para qualquer upgrade de versão principal: o Zabbix migra o esquema do banco ao iniciar a nova versão, e essa migração não se desfaz sozinha. Voltar para a versão anterior significa restaurar o banco. Por isso, backup testado e ensaio completo em homologação não são burocracia; são o plano de retorno.
Por que isso importa agora
O volume de dados de monitoramento cresce mais rápido do que os orçamentos de infraestrutura. Mais APIs, mais contêineres, mais dispositivos de borda e agora mais sinais de telemetria, como traces e logs. As plataformas comerciais de observabilidade transformaram esse volume em modelo de cobrança, e muitas empresas descobriram que o custo de guardar e consultar dados passou a ser uma linha relevante no orçamento de TI.
O movimento do Zabbix 8.0 é o de preparar o núcleo para essa nova escala sem abandonar o modelo aberto: um servidor mais eficiente, coleta de rede mais rápida, histórico plugável com opção de banco analítico, tipos de dados estruturados e uma arquitetura de alta disponibilidade com menos peças. É menos vistoso do que um novo motor de correlação ou um servidor MCP, mas é o que determina se essas novidades vão funcionar no ambiente real de cada empresa.
Visão do especialista
As melhorias de núcleo e performance aparecem menos para o público do que um widget novo ou um motor de correlação, mas são tão importantes quanto qualquer funcionalidade. Sem essas mudanças de infraestrutura, a evolução da ferramenta simplesmente não seria tecnicamente possível. Tudo o que o Zabbix 8.0 promete em observabilidade e IA depende de um servidor capaz de processar mais dados, de um armazenamento que aguente o volume e de uma arquitetura que não pare.
Sobre o ClickHouse, eu vejo a decisão dependendo de dois fatores: o tamanho da base de dados e o uso dos novos recursos de observabilidade. Ambientes grandes já têm um bom motivo para avaliar o novo backend de histórico. Mas é a adoção de logs, traces e coletas de APIs em JSON que vai tornar a migração para o ClickHouse algo natural, porque o volume e o formato desses dados pedem um banco analítico. Ainda tenho uma dúvida importante sobre as tendências: não ficou claro se, com o histórico no ClickHouse, as trends poderão continuar sendo mantidas no banco SQL tradicional. Esse é um ponto que precisaremos ver na prática, na versão final, antes de fechar qualquer recomendação de arquitetura.
O suporte a múltiplos hosts PostgreSQL é uma funcionalidade aguardada há muito tempo por administradores e DBAs. Já lidei com ambientes críticos em que os DBAs se recusaram a usar soluções de alta disponibilidade como o Patroni por insegurança diante do comportamento do Zabbix, uma aplicação que lê e escreve em altíssimo volume. Ter o próprio Zabbix preparado para conviver com o failover do banco muda essa conversa. Minhas expectativas aqui são bem altas.
As permissões para proxies e grupos de proxies resolvem uma dificuldade real de ambientes multi-tenant e de administração distribuída, em que diferentes equipes ou clientes compartilham a mesma instalação. É mais uma praticidade que passa a fazer parte do núcleo, em vez de depender de convenções e controles externos.
E sobre o upgrade, mais do que nunca, ele precisa ser bem testado, documentado e repetido até termos certeza de que tudo deu certo e nada quebrou. Calma, muito teste e paciência. É preciso controlar a ansiedade de ver todas as novidades em produção e trabalhar com um objetivo claro: nenhuma surpresa pode aparecer na hora da execução da requisição de mudança.
Conclusão
O Zabbix 8.0 não muda apenas o que a plataforma mostra, mas a forma como ela aguenta, guarda e protege os dados. SNMP mais rápido, DNS resiliente, histórico em banco analítico, JSON nativo, failover transparente do PostgreSQL e um modelo de permissões pensado para ambientes compartilhados formam a fundação sobre a qual as novidades de observabilidade e IA vão rodar. Ao mesmo tempo, a elevação dos requisitos de banco, a remoção de macros e as mudanças de API fazem deste um upgrade que merece planejamento.
No próximo artigo, vamos para a camada que todo mundo vê: o novo frontend, os widgets, a experiência de uso e o aplicativo móvel oficial do Zabbix.
Fontes
- Zabbix Roadmap (oficial)
- What’s new in Zabbix 8.0 — documentação oficial (versão de desenvolvimento)
- ClickHouse setup — documentação oficial 8.0
- Parâmetros de configuração do Zabbix Server 8.0
- ZBXNEXT-6492 — Múltiplos hosts PostgreSQL / Patroni
- ZBXNEXT-2352 — Cache e reuso de EngineID no SNMPv3
- ZBXNEXT-9185 — Permissões para proxies
- Zabbix Summit 2026 — agenda
Sobre o autor
Luciano Souza, Consultor Associado da Target Solutions.
Sobre a Target Solutions
A Target Solutions é especializada em infraestrutura de TI e redes, atuando na interseção entre operação, automação e monitoramento em escala. Com mais de 15 anos de experiência técnica, combinamos soluções open source com práticas operacionais maduras para transformar ambientes complexos em operações mais eficientes, previsíveis e escaláveis.
Como Zabbix Certified Partner e parceira oficial da Zabbix no Brasil, contamos com profissionais certificados (Expert, Professional e Specialist), com ampla experiência na implantação, evolução, sustentação N2/N3 e otimização de ambientes Zabbix corporativos de grande porte — desde arquiteturas distribuídas com proxies regionais até ambientes com milhares de ativos monitorados e integrações com ITSM e ferramentas de observabilidade.
Conheça nossos serviços Zabbix ou entre em contato para conversar com um consultor especializado.
Dúvidas sobre Zabbix?
Converse com especialistas Target sobre seu cenário de monitoramento.
Entrar em contato