Zabbix
Zabbix 8.0 LTS: quando o monitoramento aprende a enxergar, correlacionar e conversar
Toda versão LTS do Zabbix carrega um peso diferente das demais. É a versão que as empresas instalam e mantêm por anos, a que entra em contratos, em editais, em arquiteturas de referência. Por isso, quando a própria Zabbix abre o seu evento anual com uma palestra do fundador intitulada algo como “Zabbix 8.0: redefinindo a observabilidade”, vale prestar atenção. A versão está planejada para outubro de 2026, e o bloco de novidades que mais chama atenção no roadmap não é sobre um widget novo ou um template a mais: é sobre mudar a natureza do produto.
Durante mais de duas décadas, o Zabbix foi construído em torno de métricas. Um item coleta um valor, uma trigger avalia uma expressão, um evento nasce, uma ação dispara. Esse modelo é robusto, previsível e explica por que o Zabbix está em bancos, operadoras, órgãos públicos e indústrias no mundo inteiro. Mas ele sempre teve um ponto cego: o que acontece dentro da aplicação, na jornada de uma requisição que atravessa dez microsserviços, e o que acontece entre os eventos, quando cem alertas são, na verdade, um único problema.
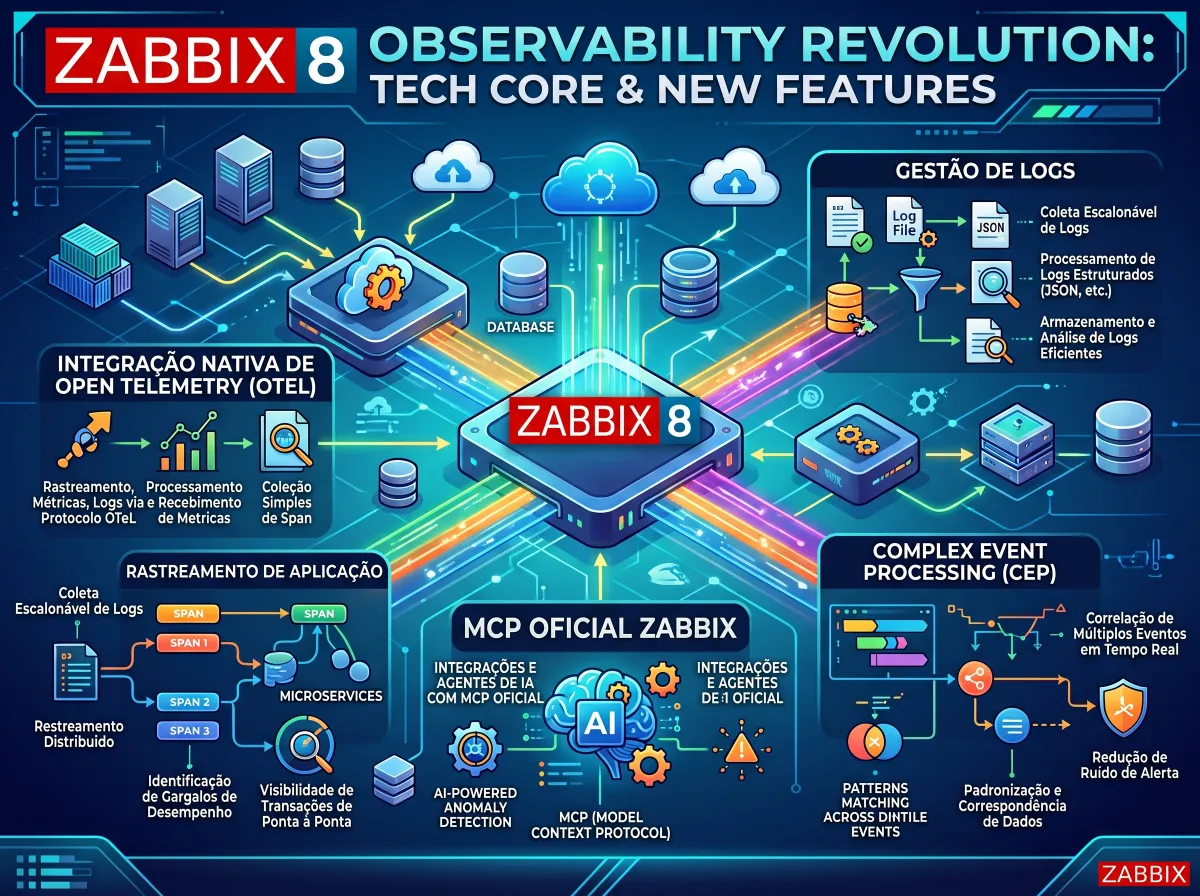
O Zabbix 8.0 ataca exatamente esses dois pontos cegos, e acrescenta um terceiro movimento: abrir a plataforma para que agentes de inteligência artificial conversem com ela de forma nativa. Neste primeiro artigo da série sobre o Zabbix 8.0 LTS, vamos destrinchar as quatro frentes que formam esse bloco — OpenTelemetry, observabilidade baseada em logs, o novo motor de processamento complexo de eventos e o servidor MCP oficial — olhando para o efeito prático de cada uma, para cenários reais de uso e para o que isso significa no mercado de observabilidade hoje.
Nota sobre o status dessas funcionalidades. No momento em que este texto foi escrito (final de setembro de 2026), a última versão pública do 8.0 era o beta2, de julho. OpenTelemetry, processamento complexo de eventos e o servidor MCP aparecem no roadmap oficial como “em desenvolvimento” e ainda não constavam nas release notes públicas. Os tickets de desenvolvimento de OpenTelemetry e do motor de eventos, porém, estão marcados para a release candidate do 8.0, e o de eventos já está em fase de documentação. Ou seja: o sinal é forte, mas detalhes de implementação podem mudar até a versão final. Tratamos aqui do que está previsto, não do que já está instalado em produção.
OpenTelemetry: o Zabbix entra no mundo dos traces
Se existe um consenso na observabilidade moderna, ele se chama OpenTelemetry. O projeto da CNCF (Cloud Native Computing Foundation) virou o padrão aberto para instrumentar aplicações e coletar métricas, logs e traces de forma neutra em relação a fornecedor. A pesquisa anual de observabilidade da Grafana Labs, publicada em 2026 com mais de 1.300 respostas, mostra que a maioria dos entrevistados já usa OpenTelemetry para métricas, metade usa para traces e quase metade para logs, com crescimento em todas as frentes em relação ao ano anterior. Outro recorte relevante da mesma pesquisa é o volume de organizações ainda em fase de prova de conceito ou investigação com OpenTelemetry — um pipeline grande de empresas se preparando para escalar.
O roadmap do Zabbix 8.0 traz duas entregas nesse campo. A primeira é a coleta de dados OpenTelemetry de forma nativa, escalável e pensada para ambientes cloud native. A segunda é uma nova visualização dedicada à busca e análise de traces. Ambas estão entre os itens mais votados pela comunidade. O próprio ticket de desenvolvimento explica a motivação sem rodeios: o Zabbix foi desenhado para métricas e não lidava bem com informação de depuração e perfilamento, como traces e logs; trazer traces para dentro da plataforma, e principalmente correlacioná-los com as métricas de infraestrutura, abriria caminho para métodos mais sofisticados de detecção e resolução de problemas.
Na prática, o efeito mais importante não é “o Zabbix agora mostra traces”. Existem ferramentas especializadas que fazem isso há anos. O efeito é que o trace passa a morar no mesmo lugar onde já moram o host, o banco de dados, o link de rede, o storage e o histórico de incidentes. Pense num e-commerce às vésperas da Black Friday: o checkout começa a ficar lento, e o time de aplicação vê no trace que o span de consulta ao estoque saltou de 40 para 900 milissegundos. Em um cenário fragmentado, alguém abre um chamado para o time de banco, que abre outro para infraestrutura, que descobre depois de uma hora que o volume do storage estava com latência de escrita alta. Quando trace e métrica de infraestrutura estão lado a lado, com o mesmo modelo de tags e o mesmo motor de eventos, essa ponte encurta drasticamente.
Outro cenário muito comum no Brasil é o de instituições financeiras e fintechs que operam fluxos transacionais críticos, com metas agressivas de tempo de resposta. Nesses ambientes, é frequente que o monitoramento de infraestrutura seja feito em Zabbix e o de aplicação em uma ferramenta de APM comercial cobrada por host ou por volume de dados. A chegada de OpenTelemetry ao Zabbix não elimina automaticamente o APM dedicado, mas muda a conversa de custo e de arquitetura: a instrumentação feita em OpenTelemetry é portável, e ter um backend open source capaz de recebê-la dá à empresa poder de escolha. A sessão sobre as novas capacidades de APM do Zabbix no Summit 2026 vai justamente nessa linha, prometendo visibilidade ponta a ponta sobre sistemas distribuídos usando o padrão OpenTelemetry.
Logs como sinal de primeira classe
O Zabbix monitora logs há muito tempo. Itens log[], logrt[] e eventlog[] são velhos conhecidos de quem administra a ferramenta. Mas o modelo sempre foi o de procurar um padrão e transformar essa ocorrência em valor para uma trigger e tendo o log como gatilho, não como fonte de investigação.
O roadmap do 8.0 fala em observabilidade baseada em logs, com foco em monitoramento em tempo real e troubleshooting usando a informação contida nos logs para entender o comportamento e a saúde dos sistemas. E para o 8.2, previsto para março de 2027, a promessa vai além: gestão centralizada de logs, coleta de syslog e uma interface avançada de análise. Isso sugere uma estratégia em duas etapas, em que o 8.0 estabelece a fundação e o 8.2 entrega a experiência completa de log management.
O efeito prático dessa mudança aparece no momento em que um alerta dispara. Hoje, o fluxo típico de um analista de NOC é receber o alerta no Zabbix, abrir uma sessão SSH ou outra ferramenta de logs, procurar o intervalo de tempo certo e tentar achar a causa. Com logs tratados como sinal de primeira classe, a investigação começa no próprio evento. Para operadoras e provedores regionais, que são uma parte enorme da base de usuários de Zabbix no Brasil, isso tem valor imediato: syslog de roteadores e switches, mensagens de BGP flap, logs de concentradores PPPoE e de OLTs deixam de ser um mundo à parte.
Tudo isso depende de uma peça menos glamourosa, porém decisiva: armazenamento. Traces e logs geram volumes que bancos relacionais tradicionais não foram feitos para suportar. O roadmap prevê suporte a novos motores de armazenamento otimizados para grandes volumes de traces, logs, séries temporais e dados de streaming, e a primeira materialização concreta disso já está na documentação do 8.0: o ClickHouse como backend para histórico de itens. Vamos aprofundar esse tema no segundo artigo da série, mas vale registrar aqui que sem essa camada de dados a ambição de observabilidade não se sustenta.
Complex Event Processing: o fim da tempestade de alertas?
Se tivéssemos que escolher uma única novidade do Zabbix 8.0 para destacar pelo impacto no dia a dia das operações, seria esta. O motor de processamento complexo de eventos (CEP, na sigla em inglês) é descrito no roadmap como uma forma de automatizar completamente o tratamento de eventos: alterar tags e severidade, filtrar, deduplicar, fechar automaticamente eventos que ficaram obsoletos, aplicar lógica baseada em janelas de tempo, fazer correspondência avançada de padrões com processamento customizado em JavaScript, anonimizar dados e mais. O próprio texto do roadmap menciona que isso habilita o Zabbix para cenários como detecção de fraude, monitoramento de segurança no estilo SIEM e correlação de eventos.
A especificação publicada no ticket de desenvolvimento ajuda a entender o desenho. Existem dois modos de operação. No primeiro, as regras atuam evento a evento, normalizando e enriquecendo: descartar, fechar ou suprimir um evento, adicionar, modificar ou remover tags. No segundo, as regras trabalham sobre um conjunto de eventos dentro de uma janela de tempo, o que permite quatro coisas que o Zabbix nunca fez de forma nativa e elegante. A primeira é o processamento diferido, como elevar a severidade ou fechar um evento depois de um período de inatividade. A segunda é o agrupamento, que inclui deduplicar e contar triggers que ficam oscilando entre problema e OK. A terceira é a detecção de padrões, em que uma combinação de eventos que atende a um critério gera um novo evento. A quarta é a detecção de ausência, que dispara um alerta quando um evento esperado não acontece dentro de um período. O mesmo ticket deixa claro outro objetivo: substituir a atual correlação global de eventos por esse novo motor, com melhor desempenho em grandes volumes.
Para entender o tamanho da mudança, é preciso lembrar como se faz correlação no Zabbix hoje. Temos dependências entre triggers, que funcionam bem para topologias simples e estáveis e viram um pesadelo de manutenção em ambientes dinâmicos. Temos a correlação baseada em tags dentro da própria trigger, útil para fechar problemas relacionados. Temos a correlação global, poderosa no conceito, mas limitada em expressividade e reconhecidamente pesada em grandes volumes. E, desde o 7.0, temos o modelo de problemas de causa e sintoma, que ajuda na visualização mas depende muito de marcação manual ou de automação externa. Quem já precisou de algo mais sofisticado acabou colocando uma camada adicional entre o Zabbix e o time de operação: um orquestrador de eventos, uma plataforma de AIOps comercial ou, com frequência, scripts próprios consumindo a API.
Agora imagine os cenários. Em um provedor de internet, um switch de agregação cai e, em segundos, duzentos equipamentos de clientes ficam inalcançáveis. Com regras de agrupamento em janela de tempo, esses duzentos eventos podem ser consolidados em torno do evento de causa, com tags enriquecidas indicando o POP e o segmento afetado, e o time recebe um incidente com contexto em vez de uma avalanche. Em um ambiente corporativo, uma trigger de uso de CPU que oscila a cada cinco minutos deixa de gerar vinte notificações por hora e passa a gerar uma, com a contagem de ocorrências registrada. Em uma rotina de backup noturno, a regra de ausência dispara quando o job não reporta sucesso até as seis da manhã, o que hoje exige truques com nodata() e itens trapper. E em segurança, cinco falhas de autenticação em hosts diferentes, para o mesmo usuário, em dez minutos, podem virar um evento novo de possível ataque de força bruta, com os dados sensíveis anonimizados antes de seguirem para uma ferramenta externa.
Esse tipo de capacidade é exatamente o que o mercado de AIOps vende como seu principal benefício. Fornecedores do setor divulgam reduções de volume de alertas na casa de 80% a 95% após a implantação de correlação, números que devem ser lidos como material de marketing, mas que apontam para uma dor real. O relatório de 2026 da NeuBird AI sobre confiabilidade em produção indica que 77% dos times de plantão recebem ao menos dez alertas por dia e que 57% afirmam que menos de 30% desses alertas são acionáveis. Não por acaso, o Summit 2026 dedica uma palestra e um workshop inteiro ao tema, com foco em análise de causa raiz, deduplicação e enriquecimento de eventos, além de uma sessão específica sobre o papel das tags no processamento complexo de eventos.
Esse último ponto merece destaque, porque é onde muitas implantações vão tropeçar. O CEP opera sobre tags. Ambientes em que as tags foram criadas sem padrão, com nomes inconsistentes e valores livres, vão descobrir que o motor mais poderoso do mundo não resolve um modelo de dados bagunçado. Não é coincidência que o mesmo 8.0 traga a visibilidade de tags herdadas de templates e hosts em itens e triggers e a possibilidade de editar tags de triggers criadas por descoberta de baixo nível. A taxonomia de tags deixa de ser boa prática e passa a ser pré-requisito.
Zabbix MCP Server: a porta oficial para agentes de IA
O Model Context Protocol, ou MCP, é um padrão aberto que permite a assistentes e agentes de IA usarem ferramentas externas de forma estruturada. Em vez de alguém copiar e colar dados do Zabbix em um chat, o agente consulta diretamente a plataforma, com permissões definidas. O roadmap do 8.0 anuncia um servidor MCP oficial do Zabbix, descrito como a forma de agentes de IA consultarem dados de monitoramento de forma programática, gerenciarem alertas e eventos e acessarem informações de configuração diretamente da instância. É outro item entre os mais votados pela comunidade.
Vale dizer que a comunidade não esperou. Já existem servidores MCP de código aberto para Zabbix, alguns cobrindo praticamente toda a API, com modos somente leitura, autenticação por token e suporte experimental ao próprio 8.0. A diferença de uma versão oficial está em três pontos: suporte e compatibilidade garantidos a cada nova versão, alinhamento com o modelo de permissões do produto e a confiança que uma área de segurança exige antes de liberar um agente de IA para conversar com o sistema que enxerga toda a infraestrutura da empresa.
Os cenários de uso aparecem rápido. Um analista de plantão às três da manhã pergunta ao assistente quais problemas estão abertos no cluster de banco de dados, o que mudou nas últimas duas horas e se há eventos semelhantes no histórico, e recebe um resumo em linguagem natural com os links para os eventos. Um gestor pede um relatório de disponibilidade dos serviços críticos do mês, cruzado com os incidentes mais longos. Um engenheiro pede ao agente para listar todos os hosts sem template de sistema operacional vinculado ou com itens não suportados há mais de sete dias. E, em fluxos mais maduros, um agente recebe o evento enriquecido pelo CEP, consulta o contexto via MCP, sugere o diagnóstico e abre o chamado já com a análise preliminar.
É importante enxergar a complementaridade entre CEP e MCP. O motor de eventos é determinístico: regras explícitas, auditáveis, com comportamento previsível. O agente de IA é probabilístico: ótimo para interpretar, resumir e sugerir, mas sujeito a erro. A arquitetura saudável usa o CEP para reduzir o ruído e estruturar o sinal, e a IA para acelerar o entendimento humano sobre esse sinal já limpo. Colocar um modelo de linguagem para ler diretamente uma tempestade de dez mil eventos crus é caro, lento e pouco confiável.
E há, claro, a questão da governança. Um servidor MCP que pode gerenciar alertas e eventos é, na prática, uma credencial com poder de ação sobre o monitoramento. Perguntas como qual usuário e qual papel o agente vai usar, se ele terá permissão de escrita ou só de leitura, onde os dados trafegam quando o modelo de IA é um serviço externo e como as ações do agente aparecem na auditoria precisam estar respondidas antes do primeiro teste em produção. O roadmap aponta que a IA não para no 8.0: o 8.2 promete “AI tools”, funcionalidades nativas movidas a IA, e o 9.0 traz novas funções de detecção de anomalias, reforçando a diretriz de continuar adicionando capacidades de IA à experiência e ao processamento de dados.
Por que isso importa agora
O mercado de observabilidade vive uma tensão clara. De um lado, a complexidade dos ambientes cresceu com nuvem, contêineres, APIs de terceiros, SaaS e agora aplicações com IA embarcada. De outro, a conta das plataformas comerciais de observabilidade, geralmente cobradas por host, por volume ingerido ou por usuário, virou tema de reunião de diretoria. O relatório de tendências de observabilidade da Elastic para 2026 aponta que IA generativa e OpenTelemetry deixaram de ser diferenciais e passaram a ser critérios básicos na escolha de plataformas — quem não investe nessas frentes tende a ficar para trás.
É nesse cenário que o Zabbix 8.0 se posiciona. Não como substituto instantâneo de todas as ferramentas especializadas, mas como uma plataforma open source, sem custo de licença, capaz de concentrar métricas, eventos, traces e logs, correlacioná-los de forma nativa e expô-los a agentes de IA por um protocolo padrão. Para empresas que já têm o Zabbix como coração do monitoramento de infraestrutura, e no Brasil isso é uma parcela enorme do mercado, a mudança de patamar pode acontecer sem trocar de ferramenta, e sim evoluindo a que já existe.
Visão do especialista
Para entender o tamanho do salto que o Complex Event Processing representa, basta olhar como a correlação de eventos é feita hoje na maioria dos ambientes Zabbix. Ela é, essencialmente, manual. O analista abre a console de problemas e marca, evento por evento, quem é causa e quem é sintoma. Quando precisa tirar ruído da tela por um tempo, usa a supressão manual de eventos. E a correlação que acontece antes do problema, de forma preventiva, depende de dependências entre triggers que alguém configurou à mão, com base em relações que já eram conhecidas. Funciona, mas depende do conhecimento e do tempo de quem opera, e não escala na mesma velocidade dos ambientes.
O que o CEP promete é transformar esse trabalho manual em regra. O conhecimento que hoje está na cabeça do analista experiente, aquele que sabe que a queda de um determinado equipamento derruba outros cinquenta, passa a poder ser expresso em lógica que o próprio Zabbix executa de forma contínua. Esse, para mim, é um dos movimentos mais importantes da versão.
Sobre o OpenTelemetry, a minha posição é de cautela. É uma evolução estratégica e muito bem-vinda, mas ainda vai precisar ser bem testada e avaliada antes de sabermos se o Zabbix poderá substituir ferramentas de mercado mais robustas e especializadas em APM e tracing. Uma coisa é trazer traces para dentro da plataforma; outra é sustentar volume, profundidade de análise e experiência de investigação no nível que esses ambientes exigem. Essa resposta vai vir da prática, e não do roadmap.
Já o servidor MCP oficial muda uma coisa fundamental: a IA deixa de ser um acessório e passa a ser algo mais próximo de um recurso nativo do Zabbix. Até agora, tudo o que existia nessa integração eram iniciativas isoladas da comunidade, algumas muito boas, mas sempre com a pergunta de compatibilidade, suporte e confiança no ar. Com um MCP mantido pela própria Zabbix, o uso de IA passa a ser integrado ao produto, e isso tende a acelerar a adoção nas empresas.
E qual é o papel da IA nesse cenário? Na minha visão, ela deve atuar na automação inteligente do ambiente, e não apenas responder perguntas. Mas isso exige bastante governança sobre o que ela pode e o que não pode fazer: quais ações são permitidas, com quais permissões, sob qual supervisão e com qual registro. E há um ponto que não é negociável: o analista continua responsável pelo que a IA fizer. A automação muda o trabalho, mas não transfere a responsabilidade.
Por fim, sobre o upgrade. Em produção, a boa prática já é esperar um pouco após o lançamento de uma nova versão. No caso do 8.0, pela quantidade e profundidade das mudanças, a recomendação é esperar ainda mais. O caminho é fazer uma avaliação cuidadosa em ambiente de teste ou homologação e explorar bem os novos recursos em laboratório antes de levar qualquer coisa para produção. Não devemos ter pressa. E, enquanto isso, fica o recado para quem trabalha com monitoramento: vai ser preciso conhecer as novas funcionalidades e a nova interface do Zabbix para se manter atualizado. O laboratório não serve só para validar o upgrade; serve também para o profissional se preparar para operar essa nova geração da ferramenta.
Conclusão
O Zabbix 8.0 não é só mais uma versão com funcionalidades novas. É a versão em que o Zabbix deixa de ser apenas um sistema de monitoramento baseado em métricas e passa a disputar espaço como plataforma de observabilidade completa, com traces, logs, correlação inteligente de eventos e integração nativa com agentes de IA. Nem tudo estará maduro no primeiro dia, e é saudável tratar o roadmap como roadmap até que o binário esteja disponível. Mas a direção está clara, e as empresas que começarem a se preparar agora vão estar à frente quando essas capacidades chegarem à produção.
No próximo artigo da série, vamos olhar para o que sustenta toda essa ambição: as melhorias de performance, escalabilidade e alta disponibilidade do núcleo, os novos tipos de dados e o novo modelo de armazenamento com ClickHouse, além do que realmente pesa na hora do upgrade.
Fontes
- Zabbix Roadmap (oficial)
- What’s new in Zabbix 8.0 — documentação oficial (versão de desenvolvimento)
- ZBXNEXT-10353 — Complex Event Processing (CEP)
- ZBXNEXT-10084 — Coleta e análise de traces (OpenTelemetry)
- Zabbix Summit 2026 — agenda
- everyWAN — Zabbix 8.0: o que é real e o que ainda é roadmap (jul/2026)
- Grafana Labs — Observability Survey 2026
- Elastic — Observability trends for 2026: GenAI and OpenTelemetry
- Clanker Cloud — dados do relatório NeuBird AI 2026 sobre fadiga de alertas
- initMAX — Zabbix MCP Server (comunitário, open source)
Sobre o autor
Luciano Souza, Consultor Associado da Target Solutions.
Sobre a Target Solutions
A Target Solutions é especializada em infraestrutura de TI e redes, atuando na interseção entre operação, automação e monitoramento em escala. Com mais de 15 anos de experiência técnica, combinamos soluções open source com práticas operacionais maduras para transformar ambientes complexos em operações mais eficientes, previsíveis e escaláveis.
Como Zabbix Certified Partner e parceira oficial da Zabbix no Brasil, contamos com profissionais certificados (Expert, Professional e Specialist), com ampla experiência na implantação, evolução, sustentação N2/N3 e otimização de ambientes Zabbix corporativos de grande porte — desde arquiteturas distribuídas com proxies regionais até ambientes com milhares de ativos monitorados e integrações com ITSM e ferramentas de observabilidade.
Conheça nossos serviços Zabbix ou entre em contato para conversar com um consultor especializado.
Dúvidas sobre Zabbix?
Converse com especialistas Target sobre seu cenário de monitoramento.
Entrar em contato