IA Agêntica
Como avaliar agentes de IA em produção: qualidade, falhas e resultados
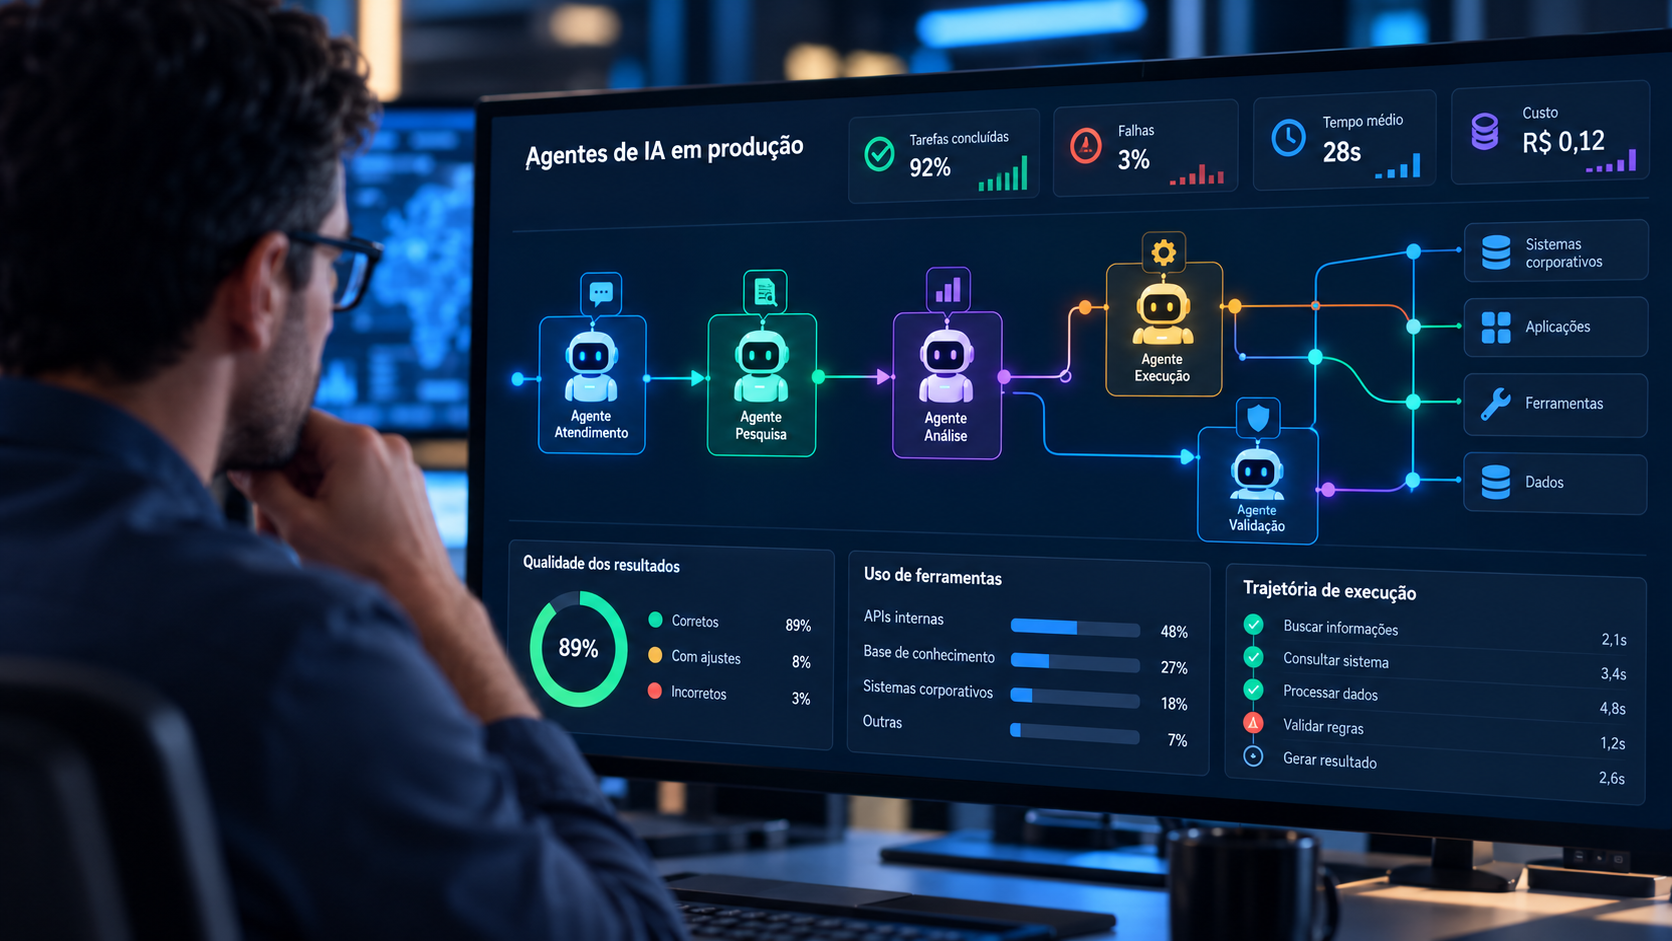
Imagine um agente de inteligência artificial responsável por atender solicitações de clientes. Ele consulta os sistemas corretamente, responde em poucos segundos e não apresenta erros técnicos durante a execução. Entretanto, deixa de realizar uma etapa necessária para resolver o problema.
Do ponto de vista do monitoramento tradicional, tudo pode parecer normal. Mas, para o cliente e para a empresa, a tarefa não foi concluída.
Esse exemplo ilustra um desafio que ganha importância à medida que agentes de IA assumem atividades mais complexas nas organizações. Um agente pode funcionar tecnicamente sem necessariamente entregar o resultado esperado.
Em junho de 2025, o Gartner projetou que mais de 40% dos projetos de IA agêntica poderiam ser cancelados até o final de 2027, devido ao aumento dos custos, à dificuldade de demonstrar valor para o negócio ou à insuficiência dos controles de risco [1].
Trata-se de uma projeção, não de uma taxa de cancelamento já observada. Ainda assim, o indicador reforça a importância de avaliar continuamente a confiabilidade e os resultados dos agentes, especialmente quando passam da experimentação para a produção.
O que significa avaliar um agente de IA
A avaliação de agentes de IA vai além de verificar se uma resposta está correta ou se determinado processamento foi concluído sem apresentar erros.
Diferentemente de aplicações convencionais, agentes podem interpretar objetivos, selecionar ferramentas, consultar informações e executar sequências de ações que variam conforme o contexto. Por isso, duas execuções de uma mesma tarefa podem seguir caminhos diferentes.
A documentação do Microsoft Foundry distingue a avaliação dos resultados da análise das etapas executadas pelo agente. Entre os critérios considerados estão a conclusão da tarefa, a aderência às instruções e a utilização adequada das ferramentas disponíveis [2].
Essa distinção é importante porque uma resposta aparentemente correta não significa necessariamente que o agente tenha seguido o processo esperado.
Considere um agente encarregado de atualizar informações cadastrais. Ele pode confirmar ao usuário que a solicitação foi atendida, mesmo sem ter efetivado a alteração no sistema. Nesse caso, a qualidade da resposta e a conclusão real da tarefa apresentam resultados diferentes.
Avaliar um agente exige verificar não apenas o que ele respondeu, mas também o que efetivamente realizou.
Isso envolve observar a qualidade da entrega, o cumprimento das instruções e a adequação das ações executadas. Quanto maior a autonomia concedida, mais relevantes se tornam esses critérios, como vimos em human-in-the-loop e autonomia.
Como identificar falhas que não aparecem na resposta final
Alguns problemas são relativamente fáceis de identificar, como uma chamada de sistema que retorna erro ou uma execução interrompida.
Outros são menos evidentes. Um agente pode utilizar uma ferramenta inadequada, consultar informações desatualizadas, repetir etapas desnecessárias ou interpretar incorretamente o resultado de uma operação.
Essas situações nem sempre produzem erros visíveis para o usuário, mas podem comprometer a qualidade, a segurança ou a eficiência do processo.
Em junho de 2026, a IBM publicou uma análise sobre testes de agentes de IA, destacando indicadores como taxa de sucesso das tarefas, precisão no uso de ferramentas e avaliação da trajetória de execução [3].
A avaliação da trajetória permite examinar a sequência de ações realizadas pelo agente, identificando se ele utilizou os recursos adequados e seguiu um caminho compatível com o objetivo estabelecido.
Esse tipo de análise complementa a observabilidade de agentes e é especialmente importante quando os agentes executam atividades em diferentes sistemas corporativos.
Um agente responsável por processar uma solicitação financeira, por exemplo, pode consultar corretamente os dados necessários, mas utilizar parâmetros inadequados ao executar uma operação. O sistema pode registrar uma execução bem-sucedida, embora o resultado produzido não corresponda ao esperado.
Ausência de erro técnico não é sinônimo de qualidade, conformidade ou conclusão correta da tarefa.
Isso não significa que toda execução precise seguir exatamente a mesma sequência. Dependendo da atividade, diferentes caminhos podem produzir resultados igualmente válidos.
O importante é estabelecer critérios que permitam diferenciar variações aceitáveis de comportamentos inadequados, considerando o objetivo da tarefa, as políticas aplicáveis e os resultados esperados.
Por que a avaliação precisa continuar em produção
A aprovação de um agente durante o desenvolvimento não garante que seu comportamento permanecerá adequado depois da implantação.
Mudanças nos modelos de IA, nas instruções, nas ferramentas disponíveis ou nas informações utilizadas podem alterar os resultados, mesmo quando o objetivo original permanece o mesmo.
O Google Cloud diferencia a avaliação da resposta final da análise da trajetória de execução, oferecendo mecanismos para comparar o comportamento dos agentes com critérios previamente definidos [4].
Essa abordagem ajuda a identificar regressões, situações em que alterações no ambiente ou na configuração provocam uma piora no desempenho anteriormente observado.
Entretanto, avaliar agentes em produção também exige considerar o contexto empresarial.
Um agente pode apresentar elevada taxa de conclusão de tarefas, mas produzir resultados que frequentemente precisam ser corrigidos por profissionais humanos. Outro pode executar atividades corretamente, porém consumir recursos excessivos ou aumentar o tempo total de atendimento.
Nesses casos, os indicadores técnicos precisam ser analisados em conjunto com a qualidade e a eficiência operacional.
A taxa de conclusão, por exemplo, pode mostrar quantas solicitações foram finalizadas. Mas é necessário compreender também quantas foram resolvidas corretamente, quantas exigiram retrabalho e se o resultado atendeu às necessidades do processo.
O desempenho de um agente não deve ser medido apenas pela quantidade de tarefas executadas, mas pela qualidade e pela utilidade dos resultados entregues.
Essa perspectiva ajuda as empresas a identificar oportunidades de melhoria, estabelecer limites adequados de autonomia e decidir quais agentes estão preparados para assumir responsabilidades maiores.
O Gartner reforçou essa preocupação em outubro de 2026, ao destacar que a ampliação da autonomia deve acompanhar a confiabilidade demonstrada pelos agentes, com avaliações contínuas de consistência, rastreabilidade, previsibilidade e segurança [5].
A questão, portanto, não é apenas colocar agentes de IA em produção, mas desenvolver a capacidade de acompanhar sua qualidade e corrigir comportamentos inadequados ao longo do tempo.
Da visão à prática: ARGUS
À medida que agentes de IA passam a participar de processos corporativos, acompanhar seu comportamento e suas ações torna-se fundamental para avaliar a confiabilidade da operação.
O ARGUS, plataforma de Inteligência Operacional e Agêntica da Target Solutions, utiliza suas capacidades de AgentOps para apoiar o monitoramento, a observabilidade e a governança dos agentes de IA.
A plataforma oferece visibilidade sobre a execução dos agentes, suas interações e o consumo de recursos, contribuindo para identificar comportamentos inesperados, investigar falhas e acompanhar indicadores operacionais.
Ao conectar agentes, pessoas e ferramentas em um contexto operacional compartilhado, o ARGUS também contribui para que as equipes compreendam melhor como as atividades são executadas em diferentes sistemas e processos.
Essa visibilidade fornece informações importantes para apoiar a avaliação contínua dos agentes, sem substituir os critérios de qualidade e os resultados de negócio que cada organização precisa estabelecer.
Conheça o ARGUS e veja como funciona na prática.
Sobre a Target Solutions
A Target Solutions é uma empresa brasileira de tecnologia especializada em soluções para ambientes críticos de TI e Telecom.
Ao longo de mais de 15 anos, participamos de projetos envolvendo infraestrutura, monitoramento, observabilidade, automação, integração de plataformas e operações de redes e serviços, trabalhando com grandes organizações e ambientes de alta complexidade.
Essa experiência nos permitiu acompanhar de perto a evolução das operações, do monitoramento tradicional à observabilidade, da automação à inteligência artificial e, agora, a ambientes nos quais agentes de IA começam a participar de processos, decisões e operações corporativas.
É nesse contexto que desenvolvemos o ARGUS, nossa plataforma de Inteligência Operacional e Agêntica, que combina capacidades de AgentOps, AI Gateway e AIOps para integrar o contexto da operação à atuação dos agentes de IA, ampliando visibilidade, governança, rastreabilidade e controle à medida que pessoas, automações, sistemas e agentes passam a compartilhar o ambiente operacional.
Sobre o autor
Paulo Florêncio de Menezes é cofundador da Target Solutions e atua há mais de 15 anos em projetos relacionados a infraestrutura, monitoramento, observabilidade, automação e operações de TI e Telecom.
É graduado em Processamento de Dados pela Universidade Federal do Amazonas (UFAM), possui MBA em Gestão Empresarial pela Fundação Dom Cabral (FDC) e Mestrado Profissional em Economia pela Fundação Getulio Vargas (FGV).
Em sua pesquisa de Mestrado, desenvolveu o IBEOP-IA (Índice Brasileiro de Exposição Ocupacional Potencial à Inteligência Artificial), investigando a exposição potencial das ocupações brasileiras às capacidades da IA por meio da combinação de dados ocupacionais, patentes de inteligência artificial e técnicas de processamento de linguagem natural.
Referências
[1] Gartner. Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027. 25 jun. 2025.
[2] Microsoft. Agent Evaluators for Generative AI. Microsoft Foundry. Documentação sobre avaliação de resultados, aderência a instruções e utilização de ferramentas por agentes de IA.
[3] IBM. Teste de agentes de IA: estratégias, métricas e melhores práticas. 25 jun. 2026.
[4] Google Cloud. Evaluate Gen AI Agents. Documentação sobre avaliação de respostas finais e trajetórias de execução de agentes.
[5] Gartner. AI Agent Success Requires Reliability Before Autonomy. 2 out. 2026.