IA Agêntica
O caminho para redes autônomas passa pelo contexto operacional compartilhado
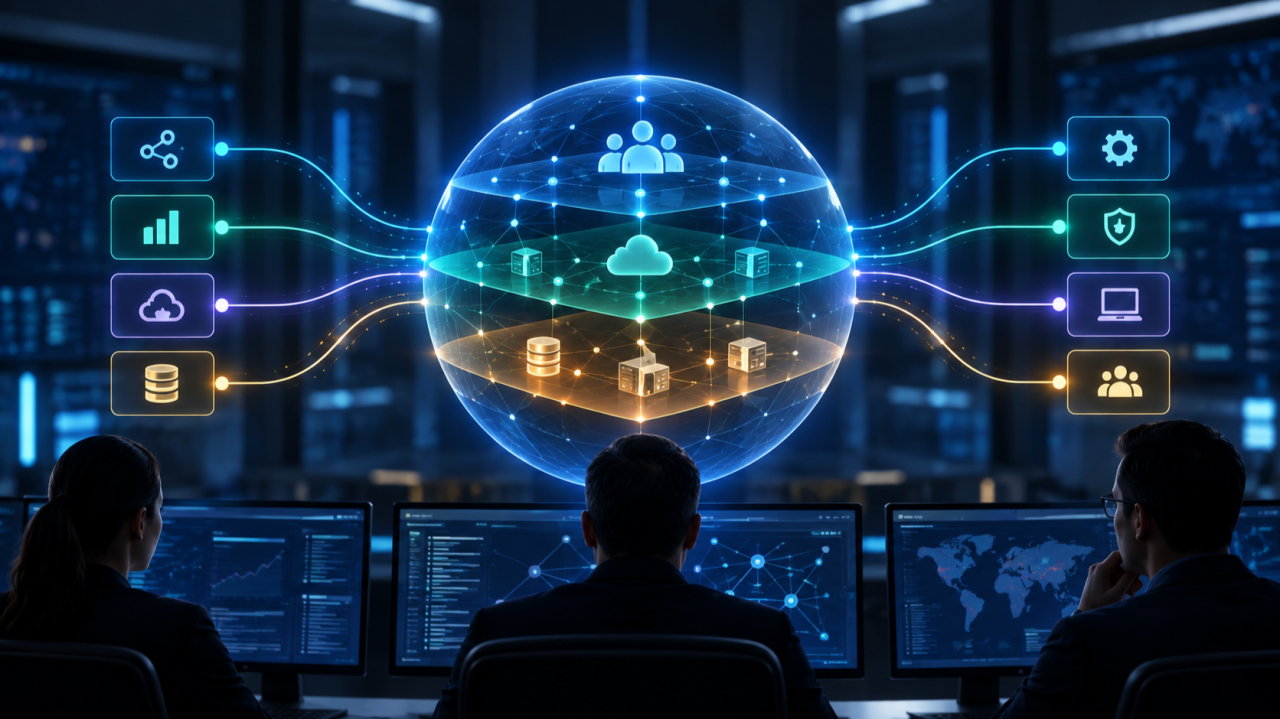
Dados podem estar disponíveis em dezenas de plataformas e ainda assim nenhuma delas possuir uma visão completa do que está acontecendo. Para que pessoas, automações e agentes consigam decidir melhor, é preciso transformar informações fragmentadas em uma compreensão compartilhada da operação.
Ter todos os dados não significa compreender o que está acontecendo
Nos últimos artigos, tenho discutido algumas das mudanças que a inteligência artificial começa a produzir nas operações de TI e Telecom. Falamos sobre autonomia, sobre a arquitetura necessária para suportá-la, sobre o risco de criarmos novos silos à medida que agentes especializados se multiplicam e, mais recentemente, sobre quanto controle estamos preparados para entregar a esses agentes.
Existe, entretanto, uma questão que atravessa praticamente todas essas discussões e talvez seja anterior à própria inteligência artificial: como construir uma compreensão suficientemente consistente daquilo que está acontecendo na operação?
Em ambientes complexos, informações raramente estão concentradas em um único lugar. Uma plataforma monitora equipamentos e interfaces, outra acompanha aplicações, ferramentas de observabilidade coletam métricas, traces e logs, o ITSM registra incidentes e mudanças, enquanto outros sistemas possuem informações sobre inventário, topologia, segurança, clientes ou desempenho. Cada um pode desempenhar muito bem sua função e, ainda assim, nenhum deles enxergar sozinho o problema completo.
Durante um incidente, essa fragmentação se torna particularmente evidente. Um equipamento pode gerar uma sequência de alarmes, outra plataforma identificar degradação em componentes relacionados, o sistema de observabilidade perceber alteração no comportamento de uma aplicação e o ITSM registrar chamados associados ao mesmo serviço. Individualmente, todos esses sinais podem estar corretos. O desafio é descobrir quais fazem parte do mesmo problema, quais são consequências e o que realmente ajuda a explicar o que aconteceu.
Ao longo dos anos, investimos muito em ampliar a visibilidade sobre infraestrutura, aplicações e serviços. Isso foi essencial para lidar com ambientes cada vez mais distribuídos e dinâmicos. Mas aumentar a quantidade de sinais disponíveis não elimina o esforço necessário para interpretá-los. Em alguns casos, produz o efeito contrário: temos mais informação e, ao mesmo tempo, mais trabalho para descobrir qual informação importa.
É por isso que uma visão única da operação não deveria ser confundida com colocar todos os dados na mesma tela.
Uma visão compartilhada não surge quando conseguimos ver todas as informações no mesmo lugar. Ela surge quando conseguimos compreender as relações entre elas.
Imagine que três plataformas informem uma falha em um componente de rede, uma degradação em determinada aplicação e aumento no número de reclamações relacionadas a um serviço. Reunir os três registros melhora a visibilidade, mas não responde à pergunta principal: existe uma relação entre eles? Para isso, precisamos compreender dependências, mudanças recentes, comportamento de elementos relacionados e outras características específicas daquele ambiente.
É nesse processo que começamos a sair da observação dos dados para a construção de contexto operacional.
Hoje, boa parte desse trabalho ainda é realizada pelas próprias pessoas. Um especialista experiente não olha apenas para o alarme que aparece na tela. Ele conhece a arquitetura, lembra de alterações recentes, entende dependências, reconhece padrões e consulta diferentes sistemas para completar aquilo que ainda não consegue explicar.
Parte importante do contexto da operação existe, portanto, na combinação entre aquilo que as ferramentas informam e aquilo que as pessoas sabem relacionar. Isso se torna uma limitação quando pretendemos aumentar a automação e, principalmente, quando agentes de IA começam a participar da análise, da decisão e da execução.
Se queremos que sistemas compreendam o suficiente para decidir, precisamos tornar explícita uma parcela do contexto que hoje ainda é construída implicitamente pelas pessoas.
Contexto operacional não é um dado que está esperando para ser encontrado
Com a popularização de LLMs, RAG, bases vetoriais e agentes capazes de consultar diferentes fontes, tornou-se mais fácil imaginar sistemas que procurem as informações necessárias antes de responder ou tomar uma decisão. Essa capacidade é extremamente útil, mas existe uma diferença importante entre recuperar informação e construir contexto.
Um documento pode explicar como determinado equipamento funciona. Uma base de conhecimento pode conter procedimentos para uma falha conhecida. Um histórico pode mostrar como incidentes semelhantes foram resolvidos. Tudo isso enriquece a análise, mas não representa necessariamente o estado atual daquela operação.
O contexto precisa combinar esse conhecimento relativamente estável com aquilo que está acontecendo agora: eventos recentes, estado dos componentes, mudanças realizadas, relações entre recursos e serviços, dependências conhecidas e informações provenientes de diferentes plataformas.
Por isso, contexto operacional não deveria ser tratado apenas como mais uma base de dados. Ele é resultado de um processo contínuo de construção e atualização.
Considere um exemplo simples. Um alarme informa que o componente A apresentou uma falha. Uma relação conhecida mostra que B depende de A. Outra ferramenta identifica degradação em B e um terceiro sistema registra impacto em um serviço C, que utiliza B. Separadamente, temos três informações. Relacionadas, elas produzem uma hipótese operacional muito mais útil sobre a cadeia de consequências daquele incidente.
Nesse exemplo, parte do contexto foi produzida dinamicamente pelos eventos e parte veio de conhecimento já existente sobre o ambiente. Essa combinação é importante porque nem tudo precisa ser inferido pela inteligência artificial.
Uma organização já conhece muitas características determinísticas de sua operação: dependências entre componentes, recursos que suportam determinados serviços, relações conhecidas entre eventos e condições que precisam ser consideradas durante uma investigação. Tornar esse conhecimento explicitamente disponível evita que um modelo precise redescobrir, a cada incidente, aquilo que a própria empresa já sabe. Ao mesmo tempo, ambientes mudam e novas correlações surgem, exigindo que esse conhecimento seja combinado continuamente com informações dinâmicas.
Essa discussão começa a aparecer de maneira cada vez mais explícita nas arquiteturas voltadas a operações autônomas. Em agosto de 2026, o TM Forum publicou o guia Context Management for AI-Native Operations, que trata contexto como a informação necessária para compreender o que está acontecendo e decidir o que fazer. A proposta procura tornar mais explícito um processo que ainda depende fortemente dos profissionais do NOC: reunir informações de múltiplas fontes, relacioná-las, construir uma visão coerente da situação e disponibilizá-la para diferentes sistemas e agentes.
O conceito se aproxima de outra discussão que abordamos anteriormente, o knowledge plane, uma camada destinada a transformar dados fragmentados em conhecimento contextualizado e reutilizável por diferentes formas de inteligência. São perspectivas complementares: uma enfatiza a construção e gestão do contexto; a outra, uma arquitetura capaz de representar e reutilizar conhecimento operacional.
Há uma consequência especialmente importante para operações críticas: esse conhecimento não precisa ser composto apenas por inferências produzidas por IA. Relações determinísticas, regras, políticas, modelos e conhecimento acumulado sobre o ambiente também podem participar dessa construção.
Quanto mais confiável for essa combinação, melhores serão as condições para que pessoas, automações e agentes interpretem a mesma situação antes de decidir o que fazer.
O contexto precisa pertencer à operação, não a uma ferramenta
Quando começamos a tratar contexto como parte da arquitetura operacional, surge outra questão: onde esse contexto deve existir?
Uma ferramenta de observabilidade conhece suas aplicações, um sistema de rede conhece seus elementos, o ITSM conhece incidentes e mudanças e, progressivamente, cada uma dessas plataformas poderá incorporar seus próprios agentes e mecanismos de inteligência. Se o contexto permanecer restrito a cada uma delas, entretanto, corremos o risco de reproduzir na inteligência artificial a mesma fragmentação que já existe entre as ferramentas.
Como discutimos no artigo anterior sobre silos de inteligência, agentes especializados continuarão sendo importantes. O problema aparece quando uma decisão depende de informações que atravessam redes, aplicações, cloud, segurança, ITSM e outros domínios.
Contexto operacional compartilhado não significa necessariamente construir uma enorme base central contendo todos os dados da empresa. Significa criar mecanismos capazes de relacionar informações e disponibilizar uma compreensão suficientemente consistente da situação para quem precisa utilizá-la.
As fontes continuam existindo, sistemas especializados continuam desempenhando suas funções e agentes podem permanecer distribuídos. O que precisa atravessar esses ambientes é o significado operacional necessário para compreender como aquilo que acontece em uma parte pode estar relacionado ao que está sendo observado em outra.
Essa necessidade aparece também na evolução das arquiteturas de Autonomous Networks do TM Forum, que caminham de inteligência dentro de domínios específicos para coordenação cross-domain. Mas o problema não é exclusivo das operadoras de Telecom nem depende da adoção integral dessa arquitetura. Qualquer operação complexa formada por múltiplas tecnologias e ferramentas enfrenta alguma versão do mesmo desafio.
É também por isso que contexto operacional deveria ser tratado como um ativo da organização, e não como propriedade de determinada ferramenta ou agente.
Ferramentas serão substituídas, modelos de IA evoluirão e novos agentes serão incorporados. A arquitetura, os serviços, as dependências, o histórico e o conhecimento acumulado sobre como aquela operação funciona, entretanto, continuam pertencendo à empresa. Preservar esse conhecimento de maneira reutilizável cria uma base sobre a qual diferentes formas de inteligência podem trabalhar.
Um especialista pode utilizá-la para investigar um incidente, uma automação pode consultá-la antes de executar uma ação e um agente pode incorporá-la ao seu raciocínio antes de produzir uma recomendação. Isso não significa que todos precisem receber exatamente as mesmas informações. Governança, segurança e finalidade continuam determinando o que cada pessoa ou sistema pode acessar.
Durante anos, grande parte do esforço de integração concentrou-se em fazer sistemas trocarem dados. APIs e conectores continuam essenciais, mas autonomia exige algo adicional: os sistemas precisam conseguir utilizar esses dados dentro de uma compreensão coerente da situação em que estão atuando.
É nesse ponto que integração e contexto deixam de ser sinônimos.
Podemos integrar dezenas de plataformas e continuar possuindo interpretações isoladas. Podemos reunir milhões de eventos e continuar dependendo de uma pessoa para descobrir quais fazem parte do mesmo problema. Podemos disponibilizar todos esses dados para um agente sofisticado e ainda exigir que ele reconstrua sozinho as relações que explicam aquela operação.
O salto acontece quando conseguimos transformar essas informações em uma representação operacional continuamente enriquecida e compartilhável.
O caminho para redes autônomas não passa apenas por tornar sistemas mais inteligentes. Passa por permitir que diferentes inteligências compreendam a mesma operação.
Esse princípio conecta as discussões dos últimos artigos. Autonomia exige confiança, confiança depende da qualidade das decisões e decisões melhores dependem não apenas do conhecimento técnico de um agente, mas também da qualidade do contexto disponível sobre aquele ambiente naquele momento.
Da visão à prática: ARGUS
Essa discussão possui uma relação particularmente direta com aquilo que temos desenvolvido no ARGUS.
O ARGUS não procura substituir as diferentes ferramentas que conhecem partes específicas da operação. Ele atua sobre esse ecossistema, conectando informações provenientes de múltiplas fontes e combinando correlação, enriquecimento e regras determinísticas para estabelecer relações entre sinais que, observados isoladamente, representam apenas fragmentos do problema.
Isso permite relacionar aquilo que está acontecendo dinamicamente no ambiente ao conhecimento que a organização já possui sobre suas próprias relações e interdependências. Eventos e alarmes de diferentes fontes podem ser correlacionados, enquanto dependências conhecidas entre componentes ajudam a construir um contexto mais consistente para compreender o que está acontecendo.
O objetivo não é simplesmente concentrar mais dados, mas ajudar a construir contexto operacional compartilhado, que possa apoiar especialistas e processos existentes e, progressivamente, também automações e agentes de IA.
É nesse ponto que a proposta do ARGUS converge com conceitos como Context Management e knowledge plane. O ARGUS não representa, sozinho, toda essa arquitetura, mas pode contribuir para sua construção ao transformar sinais distribuídos e conhecimento específico do ambiente em contexto operacional utilizável por diferentes formas de inteligência.
Conheça o ARGUS e veja como funciona na prática.
Sobre o autor
Paulo Florêncio de Menezes é cofundador da Target Solutions e atua há mais de 15 anos em projetos relacionados a infraestrutura, monitoramento, observabilidade, automação e operações de TI e Telecom.
É graduado em Processamento de Dados pela Universidade Federal do Amazonas (UFAM), possui MBA em Gestão Empresarial pela Fundação Dom Cabral (FDC) e Mestrado Profissional em Economia pela Fundação Getulio Vargas (FGV).
Em sua pesquisa de Mestrado, desenvolveu o IBEOP-IA (Índice Brasileiro de Exposição Ocupacional Potencial à Inteligência Artificial), investigando a exposição potencial das ocupações brasileiras às capacidades da IA por meio da combinação de dados ocupacionais, patentes de inteligência artificial e técnicas de processamento de linguagem natural.
Sobre a Target Solutions
A Target Solutions é uma empresa brasileira de tecnologia especializada em soluções para ambientes críticos de TI e Telecom.
Ao longo de mais de 15 anos, participamos de projetos envolvendo infraestrutura, monitoramento, observabilidade, automação, integração de plataformas e operações de redes e serviços, trabalhando com grandes organizações e ambientes de alta complexidade.
Essa experiência nos permitiu acompanhar de perto a evolução das operações: do monitoramento tradicional à observabilidade, da automação à AIOps e, agora, aos primeiros passos em direção a operações cada vez mais orientadas por inteligência artificial.
É nesse contexto que desenvolvemos o ARGUS, nossa plataforma AIOps para correlação de eventos, redução de ruído e construção de contexto operacional a partir de múltiplas fontes.