
Zabbix
Zabbix 8.0 LTS por dentro: el motor que sostiene la nueva generación del monitoreo
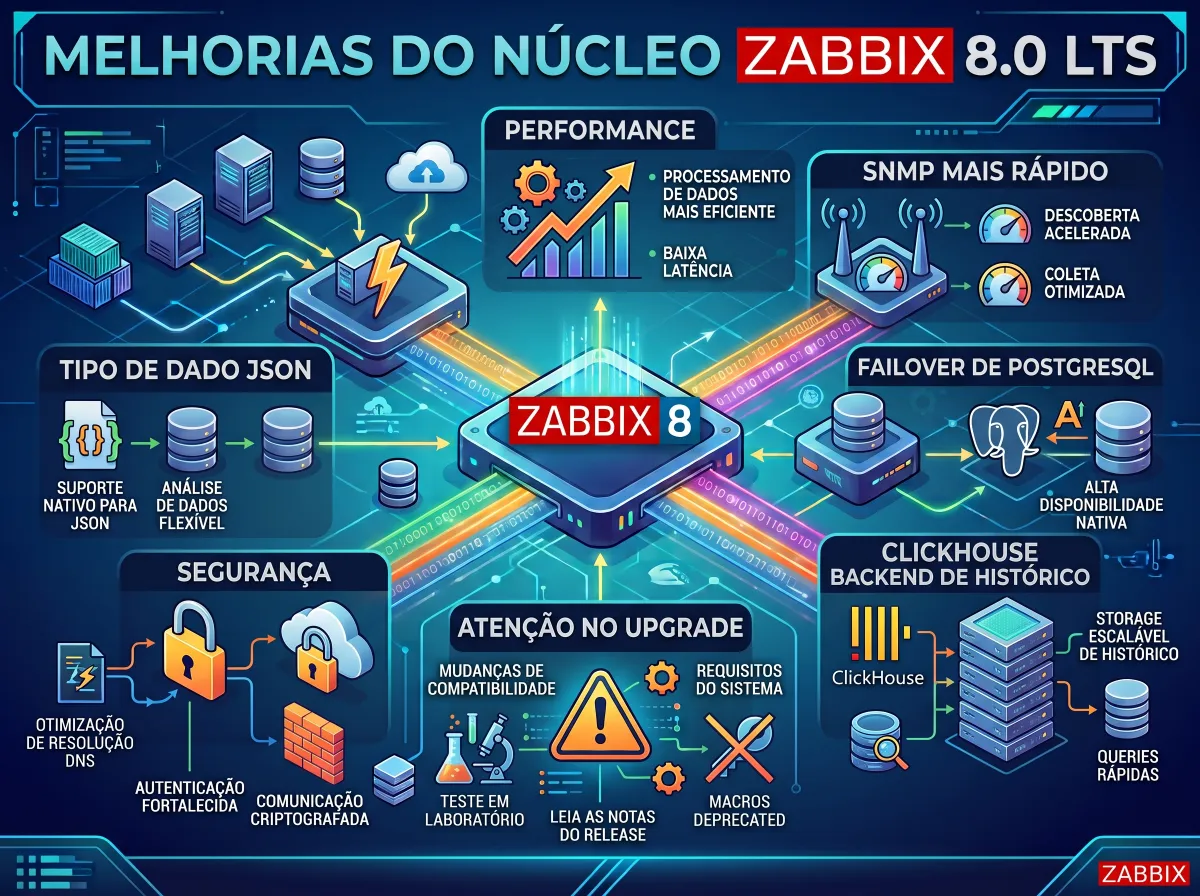
En el primer artículo de esta serie, hablamos de las novedades que más llaman la atención en Zabbix 8.0: OpenTelemetry, logs, procesamiento complejo de eventos e integración nativa con agentes de IA. Pero ninguna de estas ambiciones se sostiene sin un núcleo capaz de aguantar la carga. Los traces, los logs y los payloads estructurados multiplican el volumen de datos. La correlación de eventos en ventanas de tiempo exige procesamiento rápido. Y una plataforma que se propone ser el centro de la operación necesita ser tan disponible como los sistemas que vigila.
De ese núcleo trata este segundo artículo. Rendimiento y escalabilidad, alta disponibilidad, nuevos tipos de datos, el nuevo modelo de almacenamiento de historial y, por último, una parte que suele quedar fuera de los resúmenes de novedades, pero que decide el éxito de un proyecto: qué cambia de forma incompatible y necesita prepararse antes de la actualización.
Estado de las funcionalidades. A diferencia del bloque de observabilidad e IA, buena parte de lo que está en este artículo ya aparece en la documentación oficial de 8.0 y en las versiones alpha y beta publicadas: ClickHouse, tipo de dato JSON, soporte a múltiples hosts PostgreSQL, mejoras de SNMP y caché de DNS, entre otros. Las excepciones son las “mejoras masivas de rendimiento”, aún marcadas como en desarrollo en el roadmap, y los permisos para proxies, que están en fase de pruebas con previsión para la release candidate. La documentación consultada es la de la versión de desarrollo y puede sufrir ajustes hasta el lanzamiento, previsto para octubre de 2026.
Rendimiento y escala: rumbo al millón de valores por segundo
El roadmap de 8.0 promete mejoras masivas de rendimiento, con capacidad de recolectar millones de valores por segundo, gracias a un Zabbix Server mucho más eficiente y al soporte flexible a motores de almacenamiento pensados para implantaciones a gran escala. En el Zabbix Summit 2026, el Lead Product Owner de Zabbix tiene una charla dedicada exactamente a mostrar cómo los nuevos recursos de 8.0 permiten llegar a 1 millón de nuevos valores por segundo (NVPS). Para dimensionar el salto: uno de los casos presentados en el mismo evento es el de un operador finlandés que ejecuta una arquitectura altamente disponible con cerca de 2.500 hosts y aproximadamente 7.000 NVPS. Existen entornos mucho mayores que ese, pero el orden de magnitud muestra que 8.0 apunta a un nivel al que pocas instalaciones llegan hoy.
Es importante separar aquí lo que es promesa de lo que ya está en el código. El ítem de mejoras masivas aún está en desarrollo. Las optimizaciones que atacan cuellos de botella conocidos del día a día, en cambio, están documentadas, y son ellas las que harán diferencia primero para la mayoría de las empresas.
La primera es en SNMP, protocolo que sigue siendo la columna vertebral del monitoreo de redes. En SNMPv3, Zabbix pasa a guardar en caché y reutilizar el EngineID de los dispositivos, evitando la etapa de descubrimiento en cada consulta. El pedido original de esta mejora se abrió en la comunidad en 2014 y finalmente se entrega en el ciclo de 8.0. Además, las verificaciones SNMPv1 y SNMPv2 pasan a procesarse de forma concurrente. Para un proveedor de internet o un operador que monitorea miles de switches, routers, OLTs y radios, esto significa menos pollers ocupados, menos cola e intervalos de recolección más cortos con el mismo hardware. Y para quien migró a SNMPv3 por exigencia de seguridad y sintió el impacto en el rendimiento, es una deuda antigua que se está pagando.
La segunda es la resolución de nombres. Server, proxy y agente pasan a poder usar la biblioteca c-ares para todas las solicitudes de DNS, con caché de consultas y failover entre resolvedores. Parece un detalle, pero quien ya administró un entorno con miles de hosts registrados por nombre sabe lo que ocurre cuando el DNS se pone lento o inestable: una avalancha de hosts “inalcanzables” que parece falla de red y no lo es. Con caché y cambio automático de resolvedor, una familia entera de falsos positivos simplemente desaparece. Es el tipo de mejora que nadie nota hasta la madrugada en que evita un incidente fantasma.
Completan el paquete un arranque del servidor más rápido, con carga de historial en lote, un housekeeping optimizado, mejoras de rendimiento en el uso de Elasticsearch y un ajuste fino en el control de caudal de los proxies durante la recuperación de la caché de historial. Este último punto es relevante para quien opera entornos distribuidos: cuando un proxy queda horas desconectado y vuelve con un buffer lleno, no puede ahogar al servidor con datos atrasados. El refinamiento de este mecanismo hace más predecible la recuperación de incidentes de conectividad.
ClickHouse: cuando la base de datos relacional deja de ser suficiente
Si existe un dolor universal entre administradores de Zabbix en entornos grandes, tiene nombre: el tamaño de las tablas de historial. Particionamiento, TimescaleDB, ajustes de housekeeping, retenciones agresivas: todos los que operan Zabbix a escala ya pasaron por esa lucha. 8.0 trae una respuesta estructural: ClickHouse puede usarse como backend para almacenar el historial de valores de los ítems.
ClickHouse es una base de datos columnar, diseñada para el análisis de grandes volúmenes con alta compresión y consultas agregadas muy rápidas. En Zabbix 8.0, almacena los tipos numérico entero y decimal, carácter, log, texto y el nuevo tipo JSON. Pero hay detalles de arquitectura que deben entenderse antes de cualquier decisión, y la documentación oficial es clara sobre ellos. Zabbix no calcula ni almacena tendencias (trends) en ClickHouse, lo que significa que la estrategia de retención necesita replantearse, posiblemente extendiendo el período de historial. El housekeeper de Zabbix no borra datos en ClickHouse; la retención la controla el TTL de la propia base, que por defecto es de 31 días. ClickHouse no está soportado en los proxies. Y en clústeres con replicación y sharding, la configuración de Zabbix acepta solamente una URL, por eso la recomendación es poner un balanceador de carga delante de los nodos.
Junto con esta entrega viene un cambio de modelo que va más allá de ClickHouse. Los antiguos parámetros de almacenamiento externo de historial dan lugar a un nuevo parámetro, HistoryProvider, en el servidor, y a la variable $HISTORY_PROVIDERS, en el frontend. En la práctica, el historial deja de ser “la base de Zabbix” y pasa a ser un proveedor enchufable, que puede ser SQL, Elasticsearch o ClickHouse, incluso con tipos de valor diferentes yendo a destinos diferentes. Quien ya usa Elasticsearch como backend también se verá afectado por este cambio de configuración. Zabbix publica además scripts de migración del historial existente de MySQL o PostgreSQL a ClickHouse.
El escenario de uso más obvio es el de entornos grandes, con millones de ítems y necesidad de guardar historial bruto por más tiempo, sea por requisito regulatorio o para análisis. Otro escenario interesante es el de quien ya piensa en alimentar modelos de detección de anomalías o agentes de IA con datos de Zabbix: una base columnar es mucho más adecuada para consultas analíticas pesadas que una base transaccional. Pero ClickHouse no es una bala de plata. Introduce una nueva tecnología en la operación, con sus propios requisitos de dimensionamiento, respaldo, monitoreo y conocimiento técnico. Para muchos entornos de tamaño mediano, un PostgreSQL con TimescaleDB bien ajustado sigue siendo la elección más simple y suficiente. El Summit 2026 trae una charla y un workshop completo sobre el tema, lo que muestra el peso que Zabbix da a este cambio.
JSON como tipo de dato nativo
Hasta la versión 7.4, un JSON devuelto por una API se recolectaba en un ítem de tipo texto, se almacenaba como string y estaba limitado a 64 KB. En 8.0, JSON pasa a ser un tipo de dato de primera clase, con límite de 128 MiB y validación: los valores con claves sin comillas, comas sobrantes o corchetes desbalanceados se rechazan, en lugar de grabarse como basura silenciosa. El tipo está soportado por todos los tipos de ítem y prototipos, excepto los calculados, y también aparece en la exportación en tiempo real y en los conectores de streaming.
Existe una restricción que los resúmenes suelen omitir y que cambia la forma de modelar: los ítems de tipo JSON no pueden usarse directamente en triggers. Para alertar sobre un campo específico, el camino sigue siendo extraer el valor con un ítem dependiente de otro tipo. Además, tanto ClickHouse como Elasticsearch no aceptan arrays JSON en la raíz; el valor debe ser un objeto o un conjunto de objetos. En otras palabras, el JSON nativo cambia dónde se guarda el volumen, no cómo se alerta.
¿Dónde hace diferencia esto? En todo el monitoreo basado en APIs, que crece con cada versión. Clústeres Kubernetes, proveedores de nube, hipervisores, firewalls de nueva generación, plataformas SaaS: todos responden en JSON, muchas veces con payloads que pasaban con holgura los 64 KB. Hoy, la solución común es cortar la respuesta en el preprocesamiento y descartar el resto. Con el tipo JSON, el objeto completo queda disponible para investigación, auditoría y reprocesamiento. Y, conectando con el primer artículo de esta serie, es exactamente este tipo de dato estructurado y completo el que hace más útil una consulta hecha por un agente de IA vía MCP.
En la misma línea de modelado, 8.0 trae mejoras que parecen pequeñas, pero eran pedidos antiguos de la comunidad. Las etiquetas definidas en plantillas y hosts pasan a ser visibles en los ítems y triggers que las heredan, las etiquetas de triggers creados por descubrimiento de bajo nivel pueden editarse manualmente, y el LLD anidado gana soporte a macros. Como vimos en el artículo anterior, las etiquetas bien modeladas serán la base del procesamiento complejo de eventos, y estos cambios dejan el modelo de datos más transparente y controlable.
Alta disponibilidad: la base de datos deja de ser el eslabón débil
Zabbix tiene alta disponibilidad nativa del servidor desde la versión 6.0 y grupos de proxies con balanceo y failover desde la 7.0. El eslabón que seguía frágil era la base de datos. Muchas empresas ya ejecutan PostgreSQL en clúster con herramientas como Patroni, pero Zabbix solo aceptaba una única dirección de base de datos en la configuración del servidor y del frontend. Para que el failover de la base fuera transparente, había que poner una IP virtual, un HAProxy o algún otro componente en el medio.
8.0 resuelve esto con el soporte a múltiples hosts PostgreSQL. El pedido original, abierto en la comunidad en 2021, describía exactamente el escenario de clústeres Patroni: permitir que Zabbix conozca varias direcciones y se conecte siempre al nodo activo en casos de failover o switchover. La funcionalidad se entregó en beta1 y aparece en el roadmap como falla automática para el backend PostgreSQL.
El efecto práctico es una pieza menos en la arquitectura y un punto de falla menos. En un escenario de mantenimiento planificado de la base, el switchover ocurre sin editar archivos de configuración ni depender de una capa extra de red. En una falla real del nodo primario, Zabbix encuentra el nuevo primario por sí solo. El caso del operador finlandés presentado en el Summit, que combina servidores Zabbix en HA, un clúster PostgreSQL gestionado por Patroni en servidores físicos y seis grupos de proxies, es un retrato del tipo de arquitectura que pasa a ser más simple de montar y operar con 8.0.
Seguridad y gobernanza: Zabbix como plataforma multiusuario
Un conjunto de cambios de 8.0 apunta a entornos en los que Zabbix se comparte entre varios equipos, unidades de negocio o clientes. El más relevante es el nuevo modelo de permisos para proxies y grupos de proxies, semejante al que ya existe para grupos de hosts. El pedido nació de proveedores de servicios gestionados que necesitaban impedir que un cliente viera o eligiera proxies de otros clientes. La funcionalidad está en fase de pruebas, con previsión para la release candidate.
Otras entregas refuerzan la postura de seguridad: los certificados SAML pueden cargarse directamente por la interfaz para el inicio de sesión único, la integración con la bóveda de secretos HashiCorp Vault gana autenticación por el método AppRole, el registro de auditoría puede exportarse en CSV a partir de filtros, y los agentes ganan los parámetros AllowKeyRegexp y DenyKeyRegexp para controlar, por expresión regular, qué claves pueden ejecutarse. Las plantillas y tipos de medio basados en HTTP pasan a verificar el certificado TLS del destino por defecto, lo que es más seguro, pero puede romper integraciones que apuntan a endpoints con certificados autofirmados.
Para un organismo público que necesita comprobar en una auditoría quién modificó qué, para un banco que necesita demostrar controles de acceso o para un proveedor que opera Zabbix para decenas de clientes, este conjunto de mejoras transforma prácticas que antes dependían de disciplina y scripts en recursos nativos.
La cuenta de la actualización: qué cambia de forma incompatible
Toda versión LTS trae cambios que rompen compatibilidad, y 8.0 no es la excepción. El primero y más pesado es la elevación de las versiones mínimas de base de datos y PHP. El PostgreSQL mínimo sube de la versión 13 a la 15, MySQL de 8.0.30 a 8.4, MariaDB de 10.5 a 10.11, TimescaleDB de 2.13 a 2.20 y PHP de 8.0 a 8.2. Para muchas empresas, esto significa que actualizar Zabbix comienza por actualizar la base donde vive todo el historial, y ese suele ser el tramo más demorado y riesgoso de la ventana de mantenimiento. Para quien usa MySQL creado con el conjunto de caracteres utf8mb3, la recomendación es convertir a utf8mb4.
El segundo cambio está en las macros. 8.0 elimina de una vez macros depreciadas hace mucho tiempo, que aún sobreviven en textos de notificación de muchos entornos, como {HOSTNAME}, {IPADDRESS}, {TRIGGER.COMMENT}, {TRIGGER.KEY}, {STATUS}, {USER.ALIAS}, {PROFILE.*} y las antiguas macros de reconocimiento {ACK.*}. Todas tienen sustitutas que ya funcionan en las versiones 7.x. El riesgo aquí es silencioso: lo que se rompe no es un gráfico, es el texto de la alerta, y una alerta rota solo se percibe cuando alguien la necesita.
El tercero está en la automatización. La API pierde el método massupdate en los objetos de host, plantilla, grupo de hosts y grupo de plantillas, además de hostinterface.replacehostinterfaces. Los scripts de integración con CMDB, los pipelines de aprovisionamiento y las herramientas de “Zabbix as code” necesitan revisarse. En el preprocesamiento en JavaScript, los métodos de los objetos nativos pasan a ser de solo lectura, lo que invalida scripts que modificaban prototipos. En los agentes, el carácter % entra en la lista de UnsafeUserParameters. El plugin de Ceph del agente 2 pasa a ser un plugin cargable, con etapas extra de instalación, y los agentes anteriores a la versión 1.6 dejan de estar soportados.
Hay aún un detalle operativo que vale para cualquier actualización de versión principal: Zabbix migra el esquema de la base al iniciar la nueva versión, y esa migración no se deshace sola. Volver a la versión anterior significa restaurar la base. Por eso, un respaldo probado y un ensayo completo en homologación no son burocracia; son el plan de retorno.
Por qué esto importa ahora
El volumen de datos de monitoreo crece más rápido que los presupuestos de infraestructura. Más APIs, más contenedores, más dispositivos de borde y ahora más señales de telemetría, como traces y logs. Las plataformas comerciales de observabilidad transformaron ese volumen en modelo de cobro, y muchas empresas descubrieron que el costo de guardar y consultar datos pasó a ser una línea relevante en el presupuesto de TI.
El movimiento de Zabbix 8.0 es el de preparar el núcleo para esta nueva escala sin abandonar el modelo abierto: un servidor más eficiente, recolección de red más rápida, historial enchufable con opción de base analítica, tipos de datos estructurados y una arquitectura de alta disponibilidad con menos piezas. Es menos vistoso que un nuevo motor de correlación o un servidor MCP, pero es lo que determina si esas novedades van a funcionar en el entorno real de cada empresa.
La visión del especialista
Las mejoras de núcleo y rendimiento aparecen menos para el público que un widget nuevo o un motor de correlación, pero son tan importantes como cualquier funcionalidad. Sin estos cambios de infraestructura, la evolución de la herramienta simplemente no sería técnicamente posible. Todo lo que Zabbix 8.0 promete en observabilidad e IA depende de un servidor capaz de procesar más datos, de un almacenamiento que aguante el volumen y de una arquitectura que no se detenga.
Sobre ClickHouse, veo la decisión dependiendo de dos factores: el tamaño de la base de datos y el uso de los nuevos recursos de observabilidad. Los entornos grandes ya tienen un buen motivo para evaluar el nuevo backend de historial. Pero es la adopción de logs, traces y recolecciones de APIs en JSON la que hará que la migración a ClickHouse sea algo natural, porque el volumen y el formato de esos datos piden una base analítica. Aún tengo una duda importante sobre las tendencias: no quedó claro si, con el historial en ClickHouse, las trends podrán seguir manteniéndose en la base SQL tradicional. Ese es un punto que necesitaremos ver en la práctica, en la versión final, antes de cerrar cualquier recomendación de arquitectura.
El soporte a múltiples hosts PostgreSQL es una funcionalidad esperada hace mucho tiempo por administradores y DBAs. Ya lidié con entornos críticos en los que los DBAs se negaron a usar soluciones de alta disponibilidad como Patroni por inseguridad ante el comportamiento de Zabbix, una aplicación que lee y escribe en altísimo volumen. Tener a la propia Zabbix preparada para convivir con el failover de la base cambia esa conversación. Mis expectativas aquí son bastante altas.
Los permisos para proxies y grupos de proxies resuelven una dificultad real de entornos multitenant y de administración distribuida, en los que diferentes equipos o clientes comparten la misma instalación. Es una practicidad más que pasa a formar parte del núcleo, en lugar de depender de convenciones y controles externos.
Y sobre la actualización, más que nunca, necesita ser bien probada, documentada y repetida hasta tener certeza de que todo salió bien y nada se rompió. Calma, mucha prueba y paciencia. Es necesario controlar la ansiedad de ver todas las novedades en producción y trabajar con un objetivo claro: ninguna sorpresa puede aparecer a la hora de ejecutar la solicitud de cambio.
Conclusión
Zabbix 8.0 no cambia solamente lo que la plataforma muestra, sino la forma en que aguanta, guarda y protege los datos. SNMP más rápido, DNS resiliente, historial en base analítica, JSON nativo, failover transparente de PostgreSQL y un modelo de permisos pensado para entornos compartidos forman la base sobre la cual correrán las novedades de observabilidad e IA. Al mismo tiempo, la elevación de los requisitos de base de datos, la eliminación de macros y los cambios de API hacen de esta una actualización que merece planificación.
En el próximo artículo, pasamos a la capa que todos ven: el nuevo frontend, los widgets, la experiencia de uso y la aplicación móvil oficial de Zabbix.
Fuentes
- Zabbix Roadmap (oficial)
- What’s new in Zabbix 8.0 — documentación oficial (versión de desarrollo)
- ClickHouse setup — documentación oficial 8.0
- Parámetros de configuración de Zabbix Server 8.0
- ZBXNEXT-6492 — Múltiples hosts PostgreSQL / Patroni
- ZBXNEXT-2352 — Caché y reutilización de EngineID en SNMPv3
- ZBXNEXT-9185 — Permisos para proxies
- Zabbix Summit 2026 — agenda
Sobre Target Solutions
Target Solutions actúa desde hace más de 15 años apoyando a organizaciones en la evolución de sus operaciones de infraestructura, monitoreo, observabilidad, automatización e inteligencia operativa. A lo largo de esa trayectoria, participó en proyectos en entornos complejos de telecomunicaciones, tecnología, gobierno, energía y grandes empresas, contribuyendo a aumentar la eficiencia operativa y la confiabilidad de los servicios. Como Zabbix Certified Partner en Brasil, Target Solutions apoya la implantación, evolución, sostenimiento y optimización de entornos Zabbix corporativos, integrando el monitoreo con ITSM, observabilidad y procesos operativos a escala.
Sobre el autor
Luciano Souza, Consultor Asociado de Target Solutions.