
Zabbix
Zabbix 8.0 LTS: cuando el monitoreo aprende a ver, correlacionar y conversar
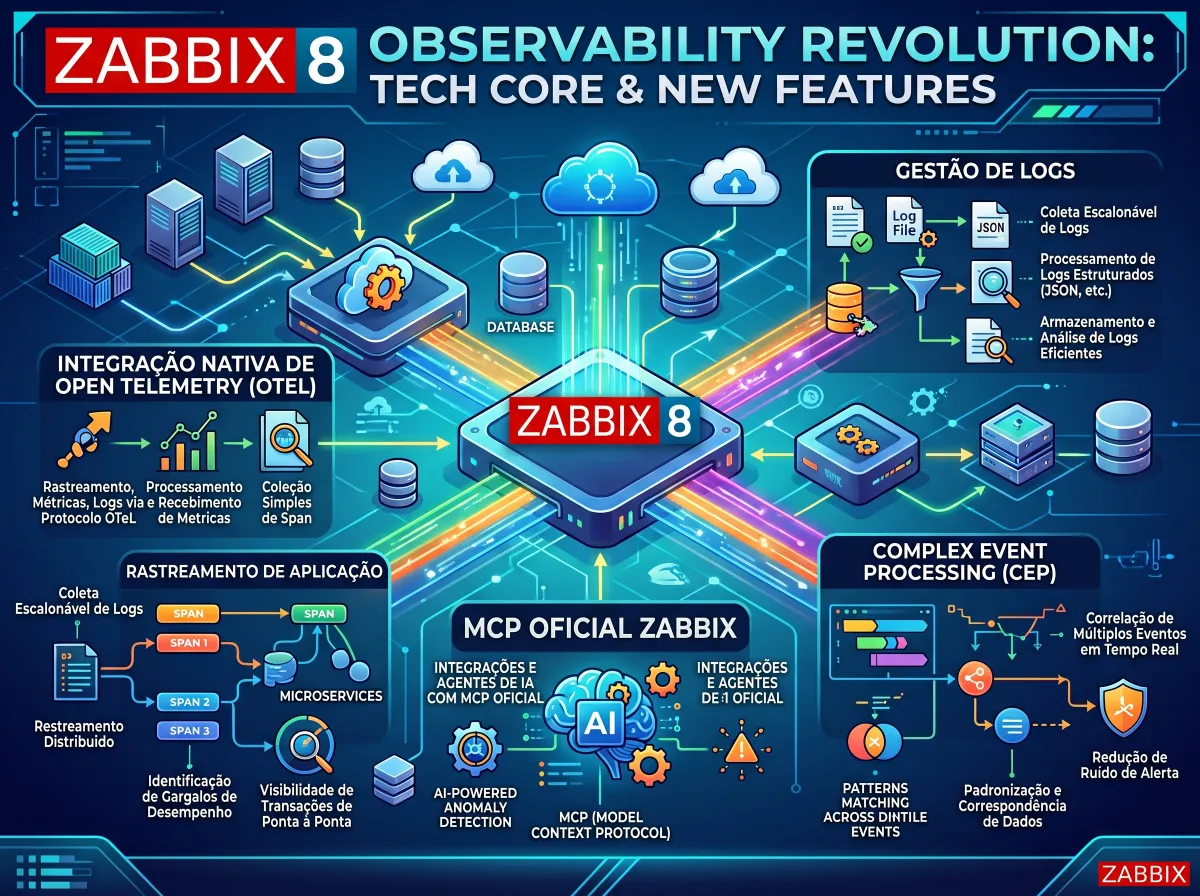
Toda versión LTS de Zabbix carga un peso diferente al de las demás. Es la versión que las empresas instalan y mantienen por años, la que entra en contratos, en licitaciones, en arquitecturas de referencia. Por eso, cuando la propia Zabbix abre su evento anual con una charla del fundador titulada algo como “Zabbix 8.0: redefiniendo la observabilidad”, vale prestar atención. La versión está planificada para octubre de 2026, y el bloque de novedades que más llama la atención en el roadmap no trata de un widget nuevo ni de una plantilla más: trata de cambiar la naturaleza del producto.
Durante más de dos décadas, Zabbix se construyó en torno a métricas. Un ítem recolecta un valor, un trigger evalúa una expresión, nace un evento, se dispara una acción. Este modelo es robusto, predecible y explica por qué Zabbix está en bancos, operadores, organismos públicos e industrias de todo el mundo. Pero siempre tuvo un punto ciego: lo que ocurre dentro de la aplicación, en el recorrido de una solicitud que atraviesa diez microservicios, y lo que ocurre entre los eventos, cuando cien alertas son, en realidad, un único problema.
Zabbix 8.0 ataca exactamente esos dos puntos ciegos, y agrega un tercer movimiento: abrir la plataforma para que agentes de inteligencia artificial conversen con ella de forma nativa. En este primer artículo de la serie sobre (PT) Zabbix 8.0 LTS, vamos a desmenuzar los cuatro frentes que forman este bloque (OpenTelemetry, observabilidad basada en logs, el nuevo motor de procesamiento complejo de eventos y el servidor MCP oficial), mirando el efecto práctico de cada uno, escenarios reales de uso y lo que esto significa en el mercado de observabilidad hoy.
Nota sobre el estado de estas funcionalidades. En el momento en que se escribió este texto (finales de septiembre de 2026), la última versión pública de 8.0 era beta2, de julio. OpenTelemetry, el procesamiento complejo de eventos y el servidor MCP aparecen en el roadmap oficial como “en desarrollo” y aún no constaban en las release notes públicas. Los tickets de desarrollo de OpenTelemetry y del motor de eventos, sin embargo, están marcados para la release candidate de 8.0, y el de eventos ya está en fase de documentación. Es decir: la señal es fuerte, pero los detalles de implementación pueden cambiar hasta la versión final. Tratamos aquí de lo que está previsto, no de lo que ya está instalado en producción.
OpenTelemetry: Zabbix entra en el mundo de los traces
Si existe un consenso en la observabilidad moderna, se llama OpenTelemetry. El proyecto de la CNCF (Cloud Native Computing Foundation) se volvió el estándar abierto para instrumentar aplicaciones y recolectar métricas, logs y traces de forma neutral respecto al proveedor. La encuesta anual de observabilidad de Grafana Labs, publicada en 2026 con más de 1.300 respuestas, muestra que la mayoría de los entrevistados ya usa OpenTelemetry para métricas, la mitad lo usa para traces y casi la mitad para logs, con crecimiento en todos los frentes respecto al año anterior. Otro recorte relevante de la misma encuesta es el volumen de organizaciones aún en fase de prueba de concepto o investigación con OpenTelemetry: un gran pipeline de empresas preparándose para escalar.
El roadmap de Zabbix 8.0 trae dos entregas en este campo. La primera es la recolección de datos OpenTelemetry de forma nativa, escalable y pensada para entornos cloud native. La segunda es una nueva visualización dedicada a la búsqueda y análisis de traces. Ambas están entre los ítems más votados por la comunidad. El propio ticket de desarrollo explica la motivación sin rodeos: Zabbix fue diseñado para métricas y no lidiaba bien con información de depuración y perfilado, como traces y logs; traer traces dentro de la plataforma, y principalmente correlacionarlos con las métricas de infraestructura, abriría camino a métodos más sofisticados de detección y resolución de problemas.
En la práctica, el efecto más importante no es “Zabbix ahora muestra traces”. Existen herramientas especializadas que lo hacen desde hace años. El efecto es que el trace pasa a vivir en el mismo lugar donde ya viven el host, la base de datos, el enlace de red, el storage y el historial de incidentes. Piense en un e-commerce en vísperas del Black Friday: el checkout empieza a ponerse lento, y el equipo de aplicación ve en el trace que el span de consulta al stock saltó de 40 a 900 milisegundos. En un escenario fragmentado, alguien abre un ticket para el equipo de bases de datos, que abre otro para infraestructura, que descubre después de una hora que el volumen del storage tenía latencia de escritura alta. Cuando trace y métrica de infraestructura están lado a lado, con el mismo modelo de etiquetas y el mismo motor de eventos, ese puente se acorta drásticamente.
Otro escenario muy común en Brasil es el de instituciones financieras y fintechs que operan flujos transaccionales críticos, con metas agresivas de tiempo de respuesta. En estos entornos, es frecuente que el monitoreo de infraestructura se haga en Zabbix y el de aplicación en una herramienta de APM comercial cobrada por host o por volumen de datos. La llegada de OpenTelemetry a Zabbix no elimina automáticamente el APM dedicado, pero cambia la conversación de costo y de arquitectura: la instrumentación hecha en OpenTelemetry es portable, y tener un backend open source capaz de recibirla le da a la empresa poder de elección. La sesión sobre las nuevas capacidades de APM de Zabbix en el Summit 2026 va justamente en esa línea, prometiendo visibilidad de punta a punta sobre sistemas distribuidos usando el estándar OpenTelemetry.
Logs como señal de primera clase
Zabbix monitorea logs desde hace mucho tiempo. Los ítems log[], logrt[] y eventlog[] son viejos conocidos de quien administra la herramienta. Pero el modelo siempre fue el de buscar un patrón y transformar esa ocurrencia en valor para un trigger, teniendo el log como gatillo, no como fuente de investigación.
El roadmap de 8.0 habla de observabilidad basada en logs, con foco en monitoreo en tiempo real y troubleshooting usando la información contenida en los logs para entender el comportamiento y la salud de los sistemas. Y para 8.2, previsto para marzo de 2027, la promesa va más allá: gestión centralizada de logs, recolección de syslog y una interfaz avanzada de análisis. Esto sugiere una estrategia en dos etapas, en la que 8.0 establece la base y 8.2 entrega la experiencia completa de log management.
El efecto práctico de este cambio aparece en el momento en que se dispara una alerta. Hoy, el flujo típico de un analista de NOC es recibir la alerta en Zabbix, abrir una sesión SSH u otra herramienta de logs, buscar el intervalo de tiempo correcto e intentar encontrar la causa. Con los logs tratados como señal de primera clase, la investigación comienza en el propio evento. Para operadores y proveedores regionales, que son una parte enorme de la base de usuarios de Zabbix en Brasil, esto tiene valor inmediato: syslog de routers y switches, mensajes de BGP flap, logs de concentradores PPPoE y de OLTs dejan de ser un mundo aparte.
Todo esto depende de una pieza menos glamorosa, pero decisiva: el almacenamiento. Los traces y los logs generan volúmenes que las bases de datos relacionales tradicionales no fueron hechas para soportar. El roadmap prevé soporte a nuevos motores de almacenamiento optimizados para grandes volúmenes de traces, logs, series temporales y datos de streaming, y la primera materialización concreta de esto ya está en la documentación de 8.0: ClickHouse como backend para el historial de ítems. Profundizaremos este tema en el segundo artículo de la serie, pero vale registrar aquí que sin esa capa de datos la ambición de observabilidad no se sostiene.
Complex Event Processing: ¿el fin de la tormenta de alertas?
Si tuviéramos que elegir una única novedad de Zabbix 8.0 para destacar por el impacto en el día a día de las operaciones, sería esta. El motor de procesamiento complejo de eventos (CEP, por sus siglas en inglés) se describe en el roadmap como una forma de automatizar completamente el tratamiento de eventos: alterar etiquetas y severidad, filtrar, deduplicar, cerrar automáticamente eventos que quedaron obsoletos, aplicar lógica basada en ventanas de tiempo, hacer correspondencia avanzada de patrones con procesamiento personalizado en JavaScript, anonimizar datos y más. El propio texto del roadmap menciona que esto habilita a Zabbix para escenarios como detección de fraude, monitoreo de seguridad al estilo SIEM y correlación de eventos.
La especificación publicada en el ticket de desarrollo ayuda a entender el diseño. Existen dos modos de operación. En el primero, las reglas actúan evento a evento, normalizando y enriqueciendo: descartar, cerrar o suprimir un evento, agregar, modificar o quitar etiquetas. En el segundo, las reglas trabajan sobre un conjunto de eventos dentro de una ventana de tiempo, lo que permite cuatro cosas que Zabbix nunca hizo de forma nativa y elegante. La primera es el procesamiento diferido, como elevar la severidad o cerrar un evento después de un período de inactividad. La segunda es la agrupación, que incluye deduplicar y contar triggers que quedan oscilando entre problema y OK. La tercera es la detección de patrones, en la que una combinación de eventos que cumple un criterio genera un nuevo evento. La cuarta es la detección de ausencia, que dispara una alerta cuando un evento esperado no ocurre dentro de un período. El mismo ticket deja claro otro objetivo: sustituir la actual correlación global de eventos por este nuevo motor, con mejor rendimiento en grandes volúmenes.
Para entender el tamaño del cambio, es preciso recordar cómo se hace correlación en Zabbix hoy. Tenemos dependencias entre triggers, que funcionan bien para topologías simples y estables y se vuelven una pesadilla de mantenimiento en entornos dinámicos. Tenemos la correlación basada en etiquetas dentro del propio trigger, útil para cerrar problemas relacionados. Tenemos la correlación global, poderosa en el concepto, pero limitada en expresividad y reconocidamente pesada en grandes volúmenes. Y, desde 7.0, tenemos el modelo de problemas de causa y síntoma, que ayuda en la visualización pero depende mucho de marcado manual o de automatización externa. Quien ya necesitó algo más sofisticado terminó poniendo una capa adicional entre Zabbix y el equipo de operación: un orquestador de eventos, una plataforma de AIOps comercial o, con frecuencia, scripts propios consumiendo la API.
Ahora imagine los escenarios. En un proveedor de internet, un switch de agregación cae y, en segundos, doscientos equipos de clientes quedan inalcanzables. Con reglas de agrupación en ventana de tiempo, esos doscientos eventos pueden consolidarse en torno al evento de causa, con etiquetas enriquecidas que indican el POP y el segmento afectado, y el equipo recibe un incidente con contexto en lugar de una avalancha. En un entorno corporativo, un trigger de uso de CPU que oscila cada cinco minutos deja de generar veinte notificaciones por hora y pasa a generar una, con el conteo de ocurrencias registrado. En una rutina de respaldo nocturno, la regla de ausencia se dispara cuando el job no informa éxito hasta las seis de la mañana, lo que hoy exige trucos con nodata() e ítems trapper. Y en seguridad, cinco fallas de autenticación en hosts diferentes, para el mismo usuario, en diez minutos, pueden convertirse en un evento nuevo de posible ataque de fuerza bruta, con los datos sensibles anonimizados antes de seguir hacia una herramienta externa.
Este tipo de capacidad es exactamente lo que el mercado de AIOps vende como su principal beneficio. Los proveedores del sector divulgan reducciones de volumen de alertas del orden del 80% al 95% tras la implantación de correlación, números que deben leerse como material de marketing, pero que apuntan a un dolor real. El informe de 2026 de NeuBird AI sobre confiabilidad en producción indica que el 77% de los equipos de guardia recibe al menos diez alertas por día y que el 57% afirma que menos del 30% de esas alertas son accionables. No por casualidad, el Summit 2026 dedica una charla y un workshop completo al tema, con foco en análisis de causa raíz, deduplicación y enriquecimiento de eventos, además de una sesión específica sobre el papel de las etiquetas en el procesamiento complejo de eventos.
Este último punto merece destaque, porque es donde muchas implantaciones van a tropezar. El CEP opera sobre etiquetas. Los entornos en los que las etiquetas se crearon sin estándar, con nombres inconsistentes y valores libres, descubrirán que el motor más poderoso del mundo no resuelve un modelo de datos desordenado. No es coincidencia que la misma versión 8.0 traiga la visibilidad de etiquetas heredadas de plantillas y hosts en ítems y triggers y la posibilidad de editar etiquetas de triggers creados por descubrimiento de bajo nivel. La taxonomía de etiquetas deja de ser buena práctica y pasa a ser prerrequisito.
Zabbix MCP Server: la puerta oficial para agentes de IA
El Model Context Protocol, o MCP, es un estándar abierto que permite a asistentes y agentes de IA usar herramientas externas de forma estructurada. En lugar de que alguien copie y pegue datos de Zabbix en un chat, el agente consulta directamente la plataforma, con permisos definidos. El roadmap de 8.0 anuncia un servidor MCP oficial de Zabbix, descrito como la forma en que los agentes de IA consultan datos de monitoreo de forma programática, gestionan alertas y eventos y acceden a información de configuración directamente desde la instancia. Es otro ítem entre los más votados por la comunidad.
Cabe decir que la comunidad no esperó. Ya existen servidores MCP de código abierto para Zabbix, algunos cubriendo prácticamente toda la API, con modos de solo lectura, autenticación por token y soporte experimental a la propia versión 8.0. La diferencia de una versión oficial está en tres puntos: soporte y compatibilidad garantizados en cada nueva versión, alineación con el modelo de permisos del producto y la confianza que un área de seguridad exige antes de liberar un agente de IA para conversar con el sistema que ve toda la infraestructura de la empresa.
Los escenarios de uso aparecen rápido. Un analista de guardia a las tres de la mañana le pregunta al asistente qué problemas están abiertos en el clúster de bases de datos, qué cambió en las últimas dos horas y si hay eventos semejantes en el historial, y recibe un resumen en lenguaje natural con los enlaces a los eventos. Un gestor pide un informe de disponibilidad de los servicios críticos del mes, cruzado con los incidentes más largos. Un ingeniero le pide al agente que liste todos los hosts sin plantilla de sistema operativo vinculada o con ítems no soportados hace más de siete días. Y, en flujos más maduros, un agente recibe el evento enriquecido por el CEP, consulta el contexto vía MCP, sugiere el diagnóstico y abre el ticket ya con el análisis preliminar.
Es importante ver la complementariedad entre CEP y MCP. El motor de eventos es determinístico: reglas explícitas, auditables, con comportamiento predecible. El agente de IA es probabilístico: excelente para interpretar, resumir y sugerir, pero sujeto a error. La arquitectura saludable usa el CEP para reducir el ruido y estructurar la señal, y la IA para acelerar el entendimiento humano sobre esa señal ya limpia. Poner a un modelo de lenguaje a leer directamente una tormenta de diez mil eventos crudos es caro, lento y poco confiable.
Y está, claro, la cuestión de la gobernanza. Un servidor MCP que puede gestionar alertas y eventos es, en la práctica, una credencial con poder de acción sobre el monitoreo. Preguntas como qué usuario y qué rol usará el agente, si tendrá permiso de escritura o solo de lectura, dónde viajan los datos cuando el modelo de IA es un servicio externo y cómo aparecen las acciones del agente en la auditoría deben estar respondidas antes de la primera prueba en producción. El roadmap señala que la IA no se detiene en 8.0: 8.2 promete “AI tools”, funcionalidades nativas impulsadas por IA, y 9.0 trae nuevas funciones de detección de anomalías, reforzando la directriz de seguir agregando capacidades de IA a la experiencia y al procesamiento de datos.
Por qué esto importa ahora
El mercado de observabilidad vive una tensión clara. Por un lado, la complejidad de los entornos creció con la nube, los contenedores, las APIs de terceros, el SaaS y ahora aplicaciones con IA embebida. Por otro, la cuenta de las plataformas comerciales de observabilidad, generalmente cobradas por host, por volumen ingerido o por usuario, se volvió tema de reunión de directorio. El informe de tendencias de observabilidad de Elastic para 2026 señala que la IA generativa y OpenTelemetry dejaron de ser diferenciales y pasaron a ser criterios básicos en la elección de plataformas: quien no invierte en esos frentes tiende a quedarse atrás.
Es en ese escenario que Zabbix 8.0 se posiciona. No como sustituto instantáneo de todas las herramientas especializadas, sino como una plataforma open source, sin costo de licencia, capaz de concentrar métricas, eventos, traces y logs, correlacionarlos de forma nativa y exponerlos a agentes de IA por un protocolo estándar. Para empresas que ya tienen Zabbix como corazón del monitoreo de infraestructura, y en Brasil eso es una parte enorme del mercado, el cambio de nivel puede ocurrir sin cambiar de herramienta, evolucionando la que ya existe.
La visión del especialista
Para entender el tamaño del salto que representa el Complex Event Processing, basta mirar cómo se hace hoy la correlación de eventos en la mayoría de los entornos Zabbix. Es, esencialmente, manual. El analista abre la consola de problemas y marca, evento por evento, cuál es causa y cuál es síntoma. Cuando necesita sacar ruido de la pantalla por un tiempo, usa la supresión manual de eventos. Y la correlación que ocurre antes del problema, de forma preventiva, depende de dependencias entre triggers que alguien configuró a mano, con base en relaciones que ya eran conocidas. Funciona, pero depende del conocimiento y del tiempo de quien opera, y no escala a la misma velocidad que los entornos.
Lo que el CEP promete es transformar ese trabajo manual en regla. El conocimiento que hoy está en la cabeza del analista experimentado, aquel que sabe que la caída de un determinado equipo derriba a otros cincuenta, pasa a poder expresarse en lógica que el propio Zabbix ejecuta de forma continua. Ese, para mí, es uno de los movimientos más importantes de la versión.
Sobre OpenTelemetry, mi posición es de cautela. Es una evolución estratégica y muy bienvenida, pero aún necesitará ser bien probada y evaluada antes de que sepamos si Zabbix podrá sustituir herramientas de mercado más robustas y especializadas en APM y tracing. Una cosa es traer traces dentro de la plataforma; otra es sostener volumen, profundidad de análisis y experiencia de investigación al nivel que esos entornos exigen. Esa respuesta vendrá de la práctica, y no del roadmap.
El servidor MCP oficial, por su parte, cambia algo fundamental: la IA deja de ser un accesorio y pasa a ser algo más cercano a un recurso nativo de Zabbix. Hasta ahora, todo lo que existía en esa integración eran iniciativas aisladas de la comunidad, algunas muy buenas, pero siempre con la pregunta de compatibilidad, soporte y confianza en el aire. Con un MCP mantenido por la propia Zabbix, el uso de IA pasa a estar integrado al producto, y eso tiende a acelerar la adopción en las empresas.
¿Y cuál es el papel de la IA en este escenario? En mi visión, debe actuar en la automatización inteligente del entorno, y no solamente responder preguntas. Pero eso exige bastante gobernanza sobre lo que puede y lo que no puede hacer: qué acciones están permitidas, con qué permisos, bajo qué supervisión y con qué registro. Y hay un punto que no es negociable: el analista sigue siendo responsable por lo que la IA haga. La automatización cambia el trabajo, pero no transfiere la responsabilidad.
Por último, sobre la actualización. En producción, la buena práctica ya es esperar un poco tras el lanzamiento de una nueva versión. En el caso de 8.0, por la cantidad y profundidad de los cambios, la recomendación es esperar aún más. El camino es hacer una evaluación cuidadosa en un entorno de prueba u homologación y explorar bien los nuevos recursos en laboratorio antes de llevar cualquier cosa a producción. No debemos tener prisa. Y, mientras tanto, queda el mensaje para quien trabaja con monitoreo: será necesario conocer las nuevas funcionalidades y la nueva interfaz de Zabbix para mantenerse actualizado. El laboratorio no sirve solo para validar la actualización; sirve también para que el profesional se prepare para operar esta nueva generación de la herramienta.
Conclusión
Zabbix 8.0 no es solo una versión más con funcionalidades nuevas. Es la versión en la que Zabbix deja de ser solamente un sistema de monitoreo basado en métricas y pasa a disputar espacio como plataforma de observabilidad completa, con traces, logs, correlación inteligente de eventos e integración nativa con agentes de IA. No todo estará maduro el primer día, y es saludable tratar el roadmap como roadmap hasta que el binario esté disponible. Pero la dirección está clara, y las empresas que empiecen a prepararse ahora estarán adelante cuando esas capacidades lleguen a producción.
En el próximo artículo de la serie, miraremos lo que sostiene toda esta ambición: las mejoras de rendimiento, escalabilidad y alta disponibilidad del núcleo, los nuevos tipos de datos y el nuevo modelo de almacenamiento con ClickHouse, además de lo que realmente pesa a la hora de la actualización.
Fuentes
- Zabbix Roadmap (oficial)
- What’s new in Zabbix 8.0 — documentación oficial (versión de desarrollo)
- ZBXNEXT-10353 — Complex Event Processing (CEP)
- ZBXNEXT-10084 — Recolección y análisis de traces (OpenTelemetry)
- Zabbix Summit 2026 — agenda
- everyWAN — Zabbix 8.0: qué es real y qué sigue siendo roadmap (jul/2026)
- Grafana Labs — Observability Survey 2026
- Elastic — Observability trends for 2026: GenAI and OpenTelemetry
- Clanker Cloud — datos del informe NeuBird AI 2026 sobre fatiga de alertas
- initMAX — Zabbix MCP Server (comunitario, open source)
Sobre Target Solutions
Target Solutions actúa desde hace más de 15 años apoyando a organizaciones en la evolución de sus operaciones de infraestructura, monitoreo, observabilidad, automatización e inteligencia operativa. A lo largo de esa trayectoria, participó en proyectos en entornos complejos de telecomunicaciones, tecnología, gobierno, energía y grandes empresas, contribuyendo a aumentar la eficiencia operativa y la confiabilidad de los servicios. Como Zabbix Certified Partner en Brasil, Target Solutions apoya la implantación, evolución, sostenimiento y optimización de entornos Zabbix corporativos, integrando el monitoreo con ITSM, observabilidad y procesos operativos a escala.
Sobre el autor
Luciano Souza, Consultor Asociado de Target Solutions.