
IA Agêntica
Incidentes con agentes de IA: cómo investigar, contener y retomar la operación
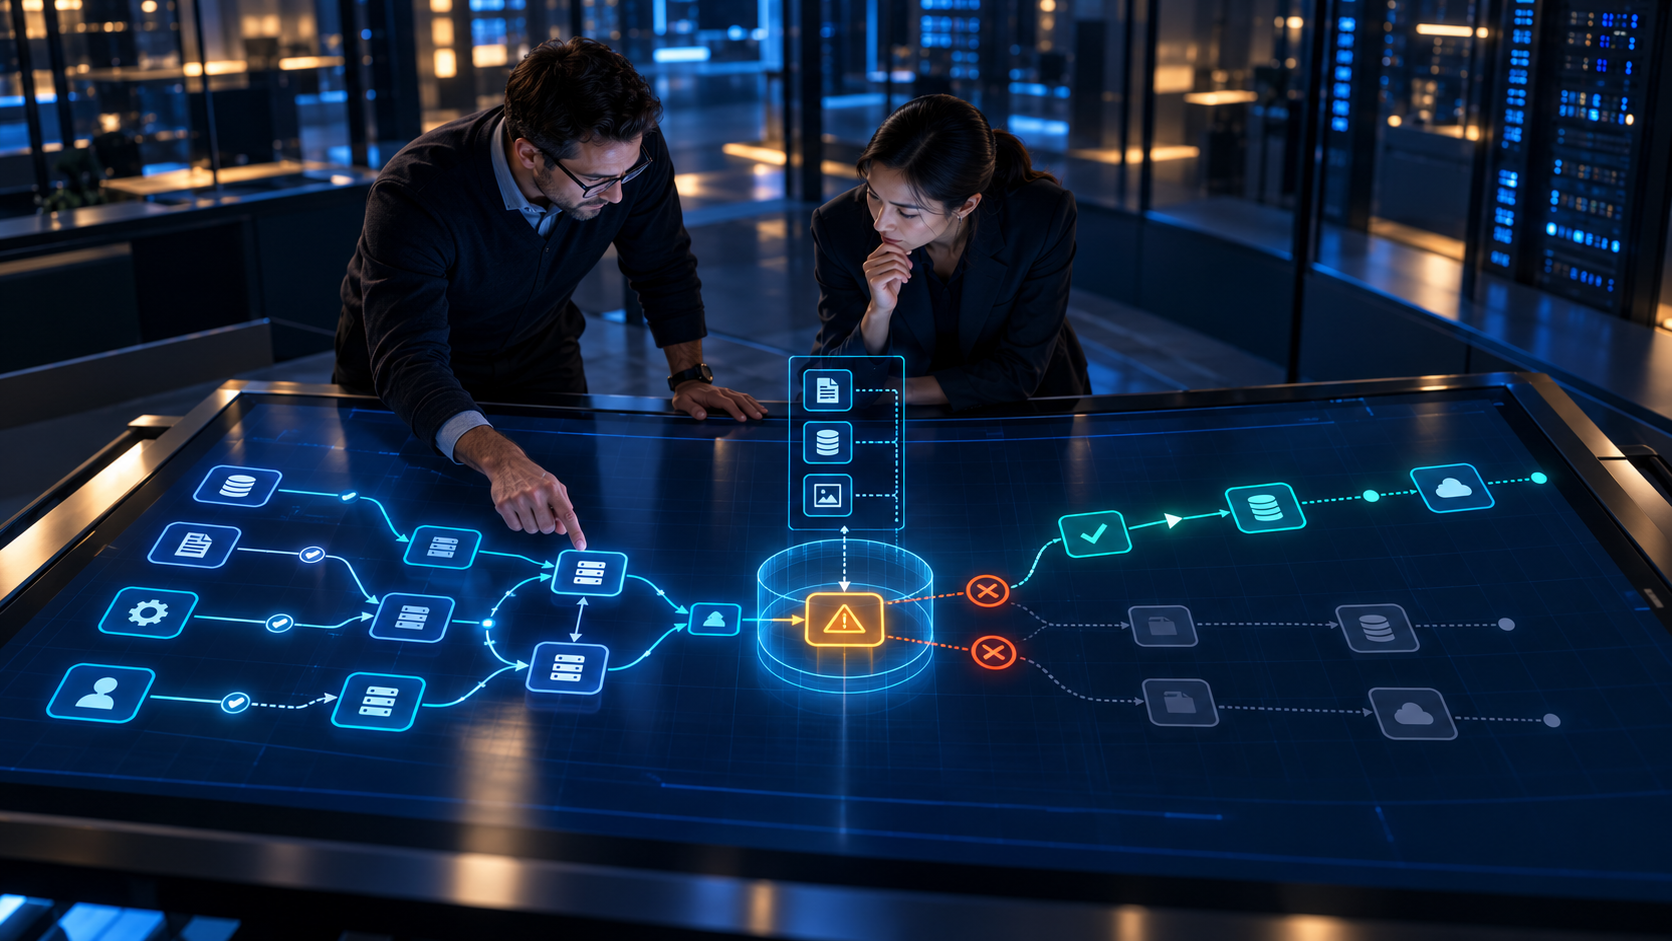
Un agente de IA puede consultar datos, seleccionar herramientas, actualizar sistemas e interactuar con otros agentes. Cuando algo sale del esperado, el problema puede superar rápidamente una respuesta incorrecta en pantalla.
El agente puede alterar un registro, crear una solicitud, enviar un mensaje o repetir una operación. Dependiendo de los permisos recibidos, una falla puede producir efectos en sistemas corporativos y alcanzar a clientes, equipos o procesos críticos.
En ese momento, observar el comportamiento es solo el comienzo.
La organización necesita limitar el impacto, preservar evidencias, entender qué ocurrió, corregir los efectos producidos y decidir cuándo la operación puede retomarse. Esa disciplina forma parte de AgentOps, el conjunto de prácticas utilizadas para operar agentes de IA en producción con control, trazabilidad y responsabilidades definidas.
Responder a un incidente con agentes exige tratar tanto el comportamiento del agente como las acciones que ya ejecutó.
Cuando una falla se transforma en incidente
No toda respuesta inadecuada necesita clasificarse como incidente.
Un error aislado, identificado antes de producir consecuencias, puede tratarse como una falla de calidad. La situación cambia cuando existe impacto real o riesgo relevante para personas, datos, procesos, sistemas o recursos financieros.
Puede ocurrir cuando el agente utiliza una herramienta fuera del flujo previsto, accede a información incompatible con la tarea, repite una operación, altera indebidamente un sistema o transfiere una solicitud sin preservar el contexto necesario.
También puede existir un incidente cuando el agente comienza a consumir recursos de forma anormal, omite una etapa de aprobación o presenta un cambio persistente de comportamiento después de una actualización.
La gravedad no depende solo de la cantidad de errores. Una sola acción puede ser crítica cuando involucra datos sensibles, movimientos financieros, operaciones esenciales o decisiones con consecuencias relevantes.
Por eso, la clasificación debe considerar el alcance de la acción, los sistemas involucrados, la posibilidad de reversión y el tiempo disponible para limitar el impacto.
La observabilidad no sustituye la respuesta a incidentes
La observabilidad permite acompañar ejecuciones, llamadas a modelos, uso de herramientas, errores, tiempo de respuesta y consumo de recursos. Las evaluaciones permiten verificar calidad, adherencia a criterios y conclusión de tareas.
Esas capacidades ayudan a detectar el problema y aportan evidencias para la investigación. Sin embargo, no definen quién puede suspender al agente, qué permisos deben revocarse, cómo tratar acciones ya ejecutadas ni quién autoriza la retomada.
La respuesta a incidentes comienza cuando las señales deben convertirse en decisiones operativas.
Ese es el punto que diferencia este tema de una discusión general sobre monitoreo. El objetivo no es solo ver el comportamiento del agente. Es organizar la reacción de la empresa cuando ese comportamiento genera impacto o riesgo relevante.
La contención puede venir antes de la causa raíz
Durante un incidente, existe la tendencia a buscar inmediatamente la causa raíz. La investigación es importante, pero no debe permitir que el agente siga produciendo acciones potencialmente perjudiciales.
Según la situación, el equipo puede suspender nuevas ejecuciones, bloquear una herramienta, interrumpir una cola, reducir permisos o revocar temporalmente las credenciales utilizadas por el agente.
En entornos con varios agentes y sistemas conectados, también es necesario observar las dependencias. Suspender un componente puede interrumpir otros flujos. Por eso, la arquitectura debe prever caminos alternativos, revisión humana o modos de operación reducidos.
AWS recomienda combinar señales comportamentales con mecanismos de interrupción, revocación de credenciales y caminos seguros para los flujos dependientes [1].
La contención debe ser rápida, pero no improvisada. Las acciones posibles deben estar previstas en procedimientos probados y asociadas a responsables con autoridad para ejecutarlas.
Cómo organizar la respuesta
Aunque cada incidente tiene características propias, una secuencia común ayuda a estructurar la actuación:
- Declarar y clasificar el incidente. Confirmar que existe impacto o riesgo relevante, definir la gravedad e identificar quién coordinará la respuesta.
- Contener el comportamiento. Interrumpir o limitar las acciones que pueden ampliar el impacto, preservando en lo posible la continuidad de los demás procesos.
- Preservar las evidencias. Registrar la ejecución, la versión del agente, el modelo, las herramientas, los permisos, las llamadas realizadas y los resultados producidos.
- Determinar el alcance. Identificar qué tareas, usuarios, datos y sistemas se vieron afectados y qué acciones llegaron a completarse.
- Corregir la causa y tratar los efectos. Ajustar el componente responsable y ejecutar las correcciones necesarias en los sistemas externos.
- Validar la recuperación. Probar la corrección en condiciones controladas, incluyendo escenarios semejantes al que produjo el incidente.
- Retomar gradualmente. Reactivar el agente con volumen, permisos o público limitados y mantener observación reforzada durante el período inicial.
Esa secuencia no necesita ser totalmente lineal. Nuevas evidencias pueden exigir volver a la investigación o ampliar la contención.
Preservar evidencias sin registrar todo indiscriminadamente
Los agentes pueden utilizar contexto temporal, memoria, herramientas externas y distintos modelos durante una sola tarea. Si el equipo simplemente interrumpe el proceso, parte de la información necesaria para la investigación puede desaparecer.
La preservación debe permitir reconstruir la secuencia desde la solicitud hasta el efecto final. Eso incluye identificar qué agente estaba en ejecución, su versión, la configuración utilizada, las herramientas disponibles, la identidad empleada y las acciones realizadas.
Llamadas, respuestas, aprobaciones humanas, errores, intentos repetidos y horarios también ayudan a explicar qué ocurrió. Esas informaciones deben compartir un identificador de rastreo para poder analizarse como una sola ejecución.
Las convenciones de IA generativa de OpenTelemetry permiten representar llamadas al modelo, invocaciones de agentes y ejecución de herramientas dentro de un rastreo distribuido [2].
Sin embargo, mensajes, instrucciones y argumentos de herramientas pueden contener información sensible. La organización debe definir qué se recopilará, quién podrá consultar los registros, cómo se protegerán y cuánto tiempo permanecerán almacenados.
Preservar evidencias no significa registrar todo el contenido sin criterios.
La investigación debe acompañar el camino de la acción
Investigar un incidente con agentes de IA no significa solo preguntar por qué el modelo produjo determinada respuesta.
Es necesario reconstruir el camino completo entre la solicitud recibida, el contexto utilizado, la decisión del agente, la herramienta accionada, la acción ejecutada y el resultado producido.
Una falla aparentemente atribuida al agente puede haber comenzado en otro punto. El contexto recuperado puede estar desactualizado. Una herramienta puede haber interpretado incorrectamente un parámetro. Una dependencia puede haber respondido de forma incompleta. Un permiso excesivo puede haber permitido una acción que debía estar bloqueada.
También es posible que el agente se haya comportado conforme su configuración, pero la propia configuración esté errónea.
La investigación debe considerar el comportamiento del agente, la calidad del contexto, las herramientas, la identidad utilizada, los permisos, la orquestación y las dependencias externas.
Los intentos de recuperación también deben analizarse. Un nuevo intento puede resolver una falla transitoria, pero puede duplicar una acción cuando la operación anterior se completó y solo se perdió la confirmación.
AWS recomienda clasificar la falla antes de elegir la recuperación. Los errores transitorios pueden admitir un nuevo intento. Las fallas persistentes pueden exigir una alternativa. Las situaciones no recuperables deben derivarse al equipo responsable [3].
Un ejemplo en un flujo empresarial
Considere un agente ficticio responsable de preparar solicitudes de compra para revisión humana.
El agente consulta los datos del pedido, verifica proveedores registrados y crea una propuesta en el sistema corporativo. La aprobación final sigue siendo responsabilidad de una persona.
Después de un cambio en la configuración, algunas respuestas de la herramienta empiezan a demorar. El agente interpreta la demora como falla y repite la operación. Como el sistema no posee protección adecuada contra duplicidad, se crean dos propuestas para la misma solicitud.
La primera señal puede ser el aumento en el número de llamadas. Luego aparecen registros duplicados y notificaciones repetidas.
El equipo suspende nuevas ejecuciones, interrumpe temporalmente la herramienta de creación y preserva los rastreos. Luego identifica todas las solicitudes procesadas en el período y separa los intentos sin efecto de las acciones que realmente crearon registros.
La corrección implica ajustar el tratamiento de los tiempos de respuesta e implementar una clave que impida la duplicidad de la misma operación. Las propuestas duplicadas deben cancelarse o corregirse antes de la retomada.
Ese ejemplo muestra por qué un cambio técnico no cierra necesariamente el incidente. Además de corregir el comportamiento futuro, el equipo debe tratar los efectos que ya se produjeron.
Restaurar una versión anterior no deshace acciones externas
La posibilidad de volver a una versión anterior es importante. Los prompts, herramientas, políticas, modelos y configuraciones deben poseer identificación e historial de cambios.
Sin embargo, el retorno de versión tiene un límite.
Si el agente envió un mensaje, actualizó un registro, abrió un ticket o aprobó una operación, restaurar su versión anterior no deshace automáticamente esas acciones.
El equipo puede necesitar corregir registros, cancelar solicitudes, revocar accesos, reprocesar tareas o solicitar nuevas aprobaciones. En algunos casos, la acción no puede deshacerse por completo, como una información ya vista o un mensaje enviado fuera de la organización.
Por eso, la arquitectura debe considerar acciones compensatorias. El retorno de versión trata el comportamiento del agente. La compensación trata los efectos dejados en los demás sistemas.
La retomada exige criterios objetivos
La presión por restablecer la operación puede llevar a la reactivación prematura del agente.
Corregir una configuración y observar una prueba exitosa no comprueba que el riesgo fue controlado. Los sistemas basados en modelos pueden presentar variaciones de comportamiento, y algunos problemas dependen del contexto o de la secuencia de ejecución.
Antes de la retomada, el equipo debe responder algunas preguntas:
- ¿Se corrigió la causa o el riesgo está suficientemente limitado?
- ¿Están adecuados los permisos, las herramientas y la configuración?
- ¿Se trataron los efectos anteriores que exigían corrección?
- ¿Las pruebas cubrieron el escenario que produjo el incidente?
- ¿Funcionan las alertas, los rastreos y los caminos alternativos?
- ¿Las áreas responsables aprobaron la retomada?
Microsoft recomienda una remediación por etapas, con contención inmediata, ampliación de controles, corrección de la causa y períodos de observación después de cada etapa [4].
La retomada puede comenzar con volumen reducido, usuarios limitados, permisos temporalmente restringidos o aprobación humana adicional.
El objetivo no es solo volver a poner el agente en funcionamiento. Es restablecer la operación en una condición conocida y controlada.
El procedimiento debe existir antes del incidente
El equipo no debe decidir durante la crisis quién puede suspender a un agente, revocar una credencial o autorizar la retomada.
Esas responsabilidades deben estar definidas con antelación. El procedimiento debe establecer criterios de gravedad, responsables técnicos y de negocio, canales de comunicación, acciones de contención disponibles y condiciones para retomar la operación.
También debe ejercitarse.
Una prueba controlada puede simular la indisponibilidad de una herramienta, un permiso excesivo, la repetición de una acción o la pérdida de contexto entre agentes. El objetivo es confirmar si la tecnología y las personas responden conforme lo esperado.
La preparación reduce el tiempo dedicado a decisiones básicas durante un incidente real.
AgentOps transforma la reacción improvisada en capacidad operacional
A medida que los agentes asumen tareas más relevantes, los incidentes dejan de ser solo una cuestión de desarrollo.
La operación debe acompañar versiones, identidades, permisos, herramientas, dependencias, evaluaciones y rastreos. También debe relacionar esos elementos con las acciones ejecutadas en los procesos de la empresa.
La observabilidad ayuda a detectar y reconstruir el comportamiento. Las evaluaciones ayudan a medir calidad. La respuesta a incidentes organiza las decisiones necesarias cuando existe impacto o riesgo relevante.
Una operación preparada puede identificar qué agente está involucrado, qué cambió, qué acciones se ejecutaron, quién se vio afectado, cómo interrumpir el comportamiento y qué condiciones permiten la retomada.
Sin esas respuestas, la empresa puede poner agentes en producción, pero seguirá dependiendo de investigación manual y decisiones improvisadas cuando algo salga del esperado.
Operar agentes de IA también significa estar preparado para interrumpir, investigar y retomar su funcionamiento con seguridad.
De la respuesta al incidente a la operación con ARGUS
Responder a un incidente con agentes de IA exige reconstruir la relación entre contexto, decisión, herramienta, acción y consecuencia. Esa investigación se vuelve más difícil cuando la información está distribuida entre plataformas de agentes, modelos, APIs, sistemas corporativos y herramientas de observabilidad.
La propuesta de AgentOps de ARGUS busca reunir visibilidad y mecanismos de gobernanza sobre la actuación de los agentes. Trazas, llamadas a herramientas, errores, consumo, versiones y resultados ayudan a comprender cómo se desarrolló una ejecución y en qué punto el comportamiento se desvió de lo esperado.
ARGUS también conecta esa visión al contexto operacional. Información sobre infraestructura, aplicaciones, servicios, eventos y dependencias ayuda a verificar si el incidente comenzó en el comportamiento del agente o fue influido por una falla en el entorno en el que estaba actuando.
Esa correlación puede apoyar la construcción de una línea de tiempo más completa, identificar los componentes involucrados y aportar evidencias para investigación, supervisión y auditoría. También ayuda a monitorear el comportamiento después de la retomada, cuando la operación debe confirmar que el agente volvió a funcionar dentro de las condiciones establecidas.
ARGUS no sustituye a los responsables del proceso, los procedimientos de contención ni las correcciones necesarias en los sistemas externos. Su propuesta es ofrecer la visibilidad y el contexto necesarios para que esas decisiones se tomen con mejores evidencias.
Conozca ARGUS y vea cómo apoya la operación y la gobernanza de agentes de IA.
Sobre Target Solutions
Target Solutions actúa hace más de 15 años apoyando organizaciones en la evolución de sus operaciones de infraestructura, monitoreo, observabilidad, automatización e inteligencia operacional.
Esa experiencia contribuye a estructurar prácticas de AgentOps orientadas a visibilidad, gobernanza y operación de agentes de IA en entornos corporativos.
Sobre el autor
Paulo Florêncio Santos de Menezes es socio y cofundador de Target Solutions, con actuación en infraestructura, monitoreo, observabilidad, automatización, operaciones de TI y gobernanza de agentes de IA.
Es graduado en Procesamiento de Datos por la Universidade Federal do Amazonas, posee MBA en Gestión Empresarial por la Fundación Dom Cabral y Maestría Profesional en Economía por la Fundación Getulio Vargas.
Referencias
[1] AMAZON WEB SERVICES. Behavioral anomaly detection and agent containment. AWS Well-Architected Agentic AI Lens, 2026.
[2] OPENTELEMETRY. Semantic conventions for generative AI systems. OpenTelemetry Documentation, 2026.
[3] AMAZON WEB SERVICES. Agent monitoring, management and recovery. AWS Well-Architected Agentic AI Lens, 2026.
[4] MICROSOFT. Incident response for AI systems. Microsoft Learn, 2026.
[5] NATIONAL INSTITUTE OF STANDARDS AND TECHNOLOGY. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1, 2024.