
AgentOps
Evaluar agentes en producción: calidad y fallos
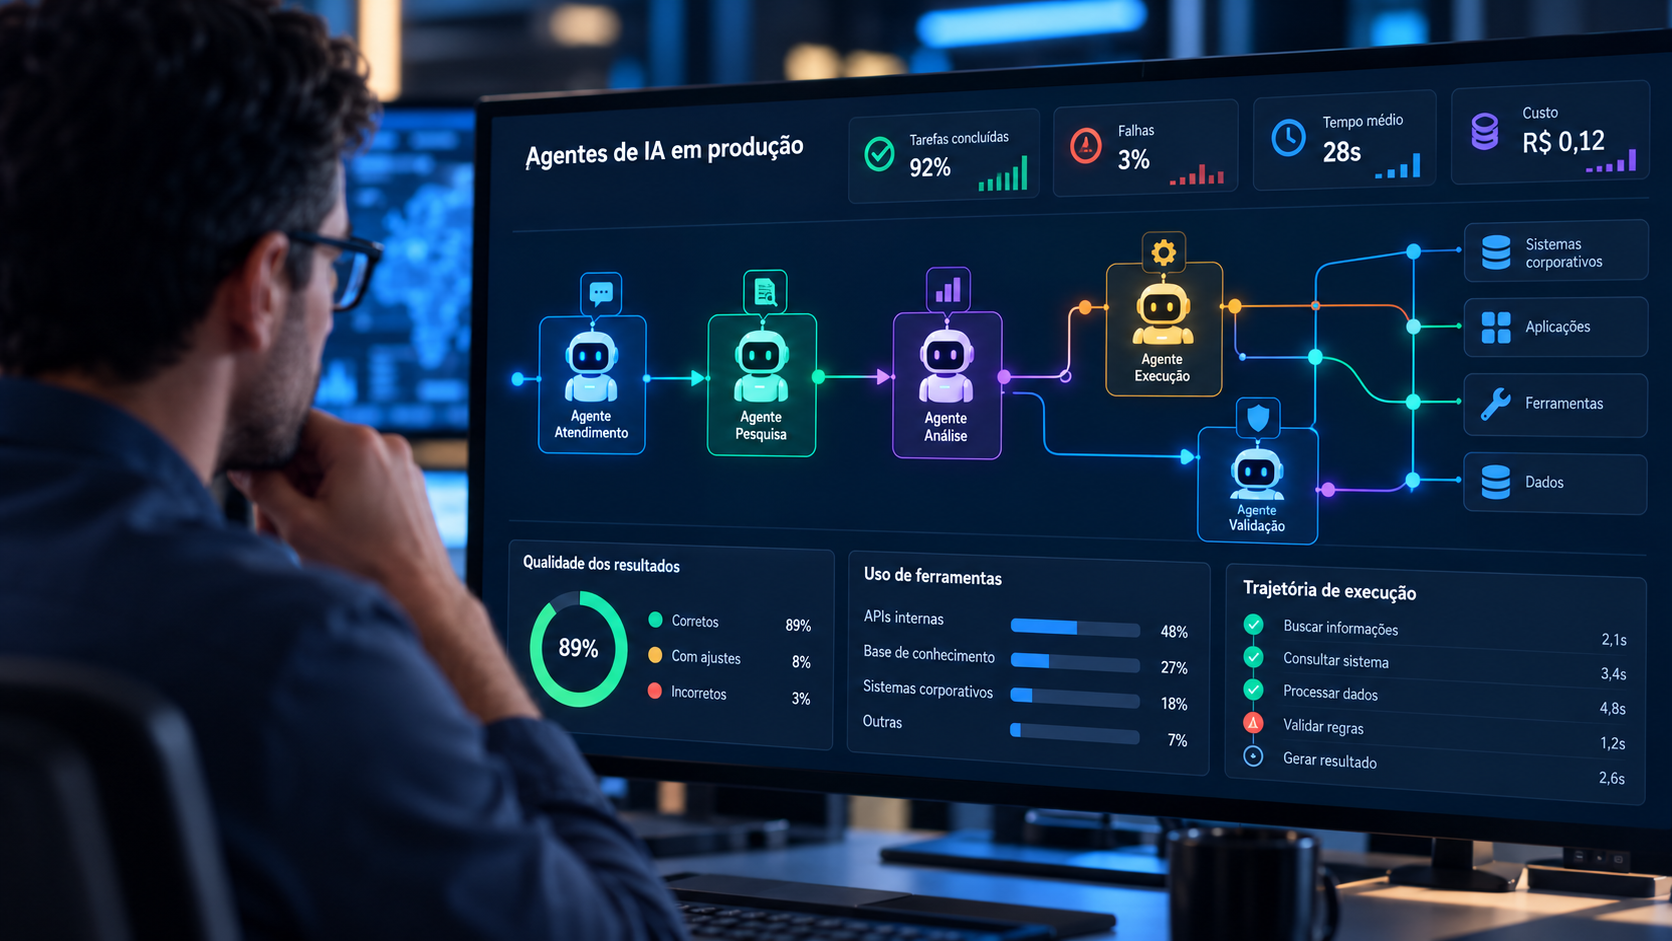
Imagine un agente de inteligencia artificial responsable de atender solicitudes de clientes. Consulta los sistemas correctamente, responde en pocos segundos y no presenta errores técnicos durante la ejecución. Sin embargo, omite un paso necesario para resolver el problema.
Desde el punto de vista del monitoreo tradicional, todo puede parecer normal. Pero, para el cliente y para la empresa, la tarea no se completó.
Este ejemplo ilustra un desafío que gana importancia a medida que los agentes de IA asumen actividades más complejas en las organizaciones. Un agente puede funcionar técnicamente sin entregar necesariamente el resultado esperado.
En junio de 2025, Gartner proyectó que más del 40% de los proyectos de IA agéntica podrían cancelarse hasta finales de 2027, debido al aumento de los costos, la dificultad para demostrar valor para el negocio o la insuficiencia de los controles de riesgo [1].
Se trata de una proyección, no de una tasa de cancelación ya observada. Aun así, el indicador refuerza la importancia de evaluar continuamente la confiabilidad y los resultados de los agentes, especialmente cuando pasan de la experimentación a la producción.
Qué significa evaluar un agente de IA
La evaluación de agentes de IA va más allá de verificar si una respuesta es correcta o si cierto procesamiento terminó sin errores.
A diferencia de las aplicaciones convencionales, los agentes pueden interpretar objetivos, seleccionar herramientas, consultar información y ejecutar secuencias de acciones que varían según el contexto. Por eso, dos ejecuciones de una misma tarea pueden seguir caminos diferentes.
La documentación de Microsoft Foundry distingue la evaluación de los resultados del análisis de los pasos ejecutados por el agente. Entre los criterios considerados están la conclusión de la tarea, la adhesión a las instrucciones y el uso adecuado de las herramientas disponibles [2].
Esa distinción es importante porque una respuesta aparentemente correcta no significa necesariamente que el agente haya seguido el proceso esperado.
Considere un agente encargado de actualizar datos de registro. Puede confirmarle al usuario que la solicitud fue atendida, aun sin haber efectuado el cambio en el sistema. En ese caso, la calidad de la respuesta y la conclusión real de la tarea arrojan resultados diferentes.
Evaluar un agente exige verificar no solo lo que respondió, sino también lo que efectivamente realizó.
Eso implica observar la calidad de la entrega, el cumplimiento de las instrucciones y la adecuación de las acciones ejecutadas. Cuanto mayor es la autonomía concedida, más relevantes se vuelven esos criterios, como vimos en human-in-the-loop y autonomía.
Cómo identificar fallos que no aparecen en la respuesta final
Algunos problemas son relativamente fáciles de identificar, como una llamada a un sistema que devuelve error o una ejecución interrumpida.
Otros son menos evidentes. Un agente puede utilizar una herramienta inadecuada, consultar información desactualizada, repetir pasos innecesarios o interpretar incorrectamente el resultado de una operación.
Estas situaciones no siempre producen errores visibles para el usuario, pero pueden comprometer la calidad, la seguridad o la eficiencia del proceso.
En junio de 2026, IBM publicó un análisis sobre pruebas de agentes de IA, destacando indicadores como la tasa de éxito de las tareas, la precisión en el uso de herramientas y la evaluación de la trayectoria de ejecución [3].
La evaluación de la trayectoria permite examinar la secuencia de acciones realizadas por el agente, identificando si utilizó los recursos adecuados y siguió un camino compatible con el objetivo establecido.
Este tipo de análisis complementa la observabilidad de agentes y es especialmente importante cuando los agentes ejecutan actividades en distintos sistemas corporativos.
Un agente responsable de procesar una solicitud financiera, por ejemplo, puede consultar correctamente los datos necesarios, pero utilizar parámetros inadecuados al ejecutar una operación. El sistema puede registrar una ejecución exitosa, aunque el resultado producido no corresponda a lo esperado.
La ausencia de error técnico no es sinónimo de calidad, conformidad ni conclusión correcta de la tarea.
Esto no significa que toda ejecución deba seguir exactamente la misma secuencia. Según la actividad, distintos caminos pueden producir resultados igualmente válidos.
Lo importante es establecer criterios que permitan diferenciar las variaciones aceptables de los comportamientos inadecuados, considerando el objetivo de la tarea, las políticas aplicables y los resultados esperados.
Por qué la evaluación debe continuar en producción
La aprobación de un agente durante el desarrollo no garantiza que su comportamiento siga siendo adecuado después del despliegue.
Los cambios en los modelos de IA, en las instrucciones, en las herramientas disponibles o en la información utilizada pueden alterar los resultados, incluso cuando el objetivo original permanece igual.
Google Cloud diferencia la evaluación de la respuesta final del análisis de la trayectoria de ejecución, y ofrece mecanismos para comparar el comportamiento de los agentes con criterios definidos previamente [4].
Este enfoque ayuda a identificar regresiones, situaciones en que cambios en el entorno o en la configuración provocan un empeoramiento del desempeño observado anteriormente.
Sin embargo, evaluar agentes en producción también exige considerar el contexto empresarial.
Un agente puede presentar una elevada tasa de conclusión de tareas, pero producir resultados que con frecuencia deben ser corregidos por profesionales humanos. Otro puede ejecutar las actividades correctamente, pero consumir recursos excesivos o aumentar el tiempo total de atención.
En esos casos, los indicadores técnicos deben analizarse junto con la calidad y la eficiencia operacional.
La tasa de conclusión, por ejemplo, puede mostrar cuántas solicitudes se finalizaron. Pero también es necesario comprender cuántas se resolvieron correctamente, cuántas exigieron retrabajo y si el resultado atendió las necesidades del proceso.
El desempeño de un agente no debe medirse solo por la cantidad de tareas ejecutadas, sino por la calidad y la utilidad de los resultados entregados.
Esta perspectiva ayuda a las empresas a identificar oportunidades de mejora, establecer límites adecuados de autonomía y decidir qué agentes están preparados para asumir mayores responsabilidades.
Gartner reforzó esta preocupación en octubre de 2026, al destacar que la ampliación de la autonomía debe acompañar la confiabilidad demostrada por los agentes, con evaluaciones continuas de consistencia, trazabilidad, previsibilidad y seguridad [5].
La cuestión, por lo tanto, no es solo poner agentes de IA en producción, sino desarrollar la capacidad de acompañar su calidad y corregir comportamientos inadecuados a lo largo del tiempo.
De la visión a la práctica: ARGUS
A medida que los agentes de IA pasan a participar en procesos corporativos, acompañar su comportamiento y sus acciones se vuelve fundamental para evaluar la confiabilidad de la operación.
ARGUS, plataforma de Inteligencia Operacional y Agéntica de Target Solutions, utiliza sus capacidades de AgentOps para apoyar el monitoreo, la observabilidad y la gobernanza de los agentes de IA.
La plataforma ofrece visibilidad sobre la ejecución de los agentes, sus interacciones y el consumo de recursos, lo que ayuda a identificar comportamientos inesperados, investigar fallos y acompañar indicadores operacionales.
Al conectar agentes, personas y herramientas en un contexto operacional compartido, ARGUS también contribuye a que los equipos comprendan mejor cómo se ejecutan las actividades en distintos sistemas y procesos.
Esa visibilidad aporta información importante para apoyar la evaluación continua de los agentes, sin sustituir los criterios de calidad y los resultados de negocio que cada organización necesita establecer.
Conozca ARGUS y vea cómo funciona en la práctica.
Sobre el autor
Paulo Florêncio de Menezes es emprendedor, socio y cofundador de empresas como Target Solutions, BiPTT y ARGUS.
Es graduado en Procesamiento de Datos por la Universidad Federal de Amazonas (UFAM), tiene MBA en Gestión Empresarial por la Fundación Dom Cabral (FDC) y Máster Profesional en Economía por la Fundación Getulio Vargas (FGV).
En su investigación de máster desarrolló el IBEOP-IA (Índice Brasileño de Exposición Ocupacional Potencial a la Inteligencia Artificial), investigando la exposición potencial de las ocupaciones brasileñas a las capacidades de la IA mediante la combinación de datos ocupacionales, patentes de inteligencia artificial y técnicas de procesamiento de lenguaje natural.
Referencias
[1] Gartner. Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027. 25 jun. 2025.
[2] Microsoft. Agent Evaluators for Generative AI. Microsoft Foundry. Documentación sobre evaluación de resultados, adhesión a instrucciones y uso de herramientas por agentes de IA.
[3] IBM. Teste de agentes de IA: estratégias, métricas e melhores práticas. 25 jun. 2026.
[4] Google Cloud. Evaluate Gen AI Agents. Documentación sobre evaluación de respuestas finales y trayectorias de ejecución de agentes.
[5] Gartner. AI Agent Success Requires Reliability Before Autonomy. 2 oct. 2026.